Von „Warum Geometrie Gewichte nicht komprimiert" — zur Architektur, die diese Asymmetrie erzeugt.
Datum: 2026-09-16 · Autor: Millog · Lizenz: CC BY-SA 4.0
Daten und Code: cmq_experiment/tied_vs_untied/ (Experimente H1–H4, Exp5–7), cmq_experiment/results_v6/ (Quantisierungsstudie)
Zusammenfassung
Wir testen die Hypothese, dass Weight Tying — eine architektonische Einschränkung, die für kleine LLM Standard ist — als impliziter Regularisierer wirkt: Gradienteninterferenz auf der gemeinsamen Eingabe-/Ausgabematrix verformt den Embedding-Raum zu einem anisotropen Kegel, und das Netz kompensiert dies, indem es irgendwo tief im Stack einen niederdimensionalen Attraktor (dynamisches Stundenglas) baut. Wir haben dies direkt an sechs lokalen Base-Modellen mit 0.135B bis 5.12B Parametern gemessen, einschließlich des Kontrollpaars „tied vs. untied" (Qwen2.5-0.5B und TinyLlama-1.1B), bei dem die Einschränkung in einem der beiden Modelle entfernt ist.
Ergebnisse: (1) Es gibt keine Gradienten-Opposition — die Pfade sind überall orthogonal (|cos| ≤ 0.023); Interferenz erscheint als Dominanz eines Pfads („Tyrannei des Ausgabepfads" in 4 von 6 Modellen, Inversion auf dem Eingangspfad bei Gemma). (2) Das Stundenglas ist an 5 von 6 Modellen bestätigt; die Kompressionszone erstreckt sich über bis zu 62% der Stacktiefe — die „Halsstelle" ist nicht eine Schicht, sondern ein breites Band. (3) Die spektrale Asymmetrie „Gesetz vs. Trajektorie" ist bestätigt: vollrangige dichte Gewichte gegen niederdimensionale Aktivierungen — dies ist der Mechanismus des Scheiterns der geometrischen Gewichtskompression in unserer früheren Studie. (4) Die Cross-Modell-Analyse zeigt einen generationsspezifischen Drift der Form niederdimensionaler Zonen: vom frühen Flaschenhals am Eingang (Qwen2.5, TinyLlama), über zentrierte Stundengläser (SmolLM) zur Verschmelzung komprimierter Schichten an der Taille (Qwen3-4B — drei Minima L7/L11/L17) und weiter zu einem verteilten Regime ohne Mittelstack-Kompression (Gemma-4, Sliding-Window-Attention). (5) Die „Massendruck"-Hypothese ist lokal bis 8192 Token widerlegt: Weder Qualitätsdegradation noch lost-in-the-middle reproduzieren sich — die Geometrie ist flach bezüglich der Kontextlänge.
Einleitung
Berechnungsfleisch und die Illusion des Verständnisses
Sprache ist „Berechnungsfleisch". Um ihre Architektur zu verstehen, muss man aufhören zu fragen „Was macht das Modell?" und anfangen zu fragen „Wie berechnet es das?". Wir können in ein neuronales Netz nicht wie in Programmcode hineinschauen, aber wir können seinen internen Zustand messen.
Dieser Artikel ist eine Fortsetzung meiner früheren Studie „Warum Geometrie Gewichte nicht komprimiert" (siehe cmq_experiment/results_v6/). Dort habe ich gezeigt, dass Aktivierungen von LLMs in einem schmalen Kegel liegen: 90% der Energie — in ~1–3 Hauptkomponenten, während die Gewichte vollrangig und dicht sind. Alle geometrischen Techniken zur Gewichtskompression (Hadamard-Rotation, Lloyd-Max, konische Dekomposition, QJL) gaben null oder negativ; der einzige funktionierende Hebel — data-adaptive Fehlerkompensation (GPTQ). Die Endformel: Gewichte = Gesetz der Dynamik, Aktivierungen = Trajektorie auf einem niederdimensionalen Attraktor.
Aber die Hauptfrage blieb offen: was erzeugt diese Asymmetrie? Warum führt Training zu dichten Gewichten und schmalen Repräsentationen? Ich habe eine Hypothese architektonischen Ursprungs aufgestellt: das Verknüpfen der Eingabe- und Ausgabematrix ist ein impliziter Regularisierer, der den Embedding-Raum zu einem Kegel verformt. Und wenn dieser Kegel existiert, dann muss das Netz irgendwo in der Tiefe die Information „komprimieren" auf niedrige Dimensionalität und am Ausgang wieder „expandieren". Das sind die dynamischen Stundengläser: nicht eine statische Struktur der Gewichte, sondern ein Muster, das entsteht, wenn Daten durch das Modell fließen.
In diesem Artikel testen wir vier Hypothesen, aus denen sich dieses Bild ergibt:
- H1 — Gradienteninterferenz. Wenn Eingabe- und Ausgabematrix dieselbe sind, dann interferieren die Gradienten des Eingabepfads (Embedding) und des Ausgabepfads (lm_head) auf der gemeinsamen Matrix. Das erzeugt einen Optimierungs-Konflikt: Der Eingabepfad zieht die Embeddings in eine Richtung, der Ausgabepfad in die andere. Ergebnis — anisotrope Verformung des Embedding-Raums.
- H2 — Stundenglas. Wenn der Raum am Eingang komprimiert ist (Kegel), dann muss irgendwo in der Mitte des Netzes eine „Expansion" auf volle Dimensionalität stattfinden, damit das Modell Informationen verarbeiten kann, und danach wieder eine „Kompression" für den Ausgang. Das erzeugt ein Profil der effektiven Dimensionalität über die Schichten: schmal → breit → schmal.
- H3 — Spektrale Asymmetrie. Gewichte sollten vollrangig sein (hohe effektive Dimensionalität), Aktivierungen niederdimensional (niedrige effektive Dimensionalität). Dies ist eine direkte Folge von H1 und H2: Gewichte sind als „Gesetz" kodiert (dicht, vom Training geglättet), Repräsentationen — als „Trajektorie auf einem Attraktor".
- H4 — Massendruck. Wenn das Modell niederdimensionale Repräsentationen zur Ersparnis von Berechnung nutzt, dann sollte es bei wachsender Kontextlänge stärker degradieren als ein Modell mit vollrangigen Repräsentationen. Dies ist die „lost in the middle"-Vorhersage als geometrischer Effekt: Ein niederdimensionaler Raum kann Informationen aus allen Positionen eines langen Kontexts nicht fassen.
Experimentelles Design: Für jede Hypothese gibt es eine direkte Messung (Kontrollpaar tied vs. untied) und eine Cross-Modell-Erweiterung (6 Modelle von 0.135B bis 5.12B). Ergebnis: Zwei Hypothesen wurden bestätigt (H2 — an fünf von sechs Modellen, H3), eine wurde in anomaler Form bestätigt (H1: nicht Gradienten-Opposition, sondern Tyrannei eines Pfads), und die vierte ist lokal widerlegt (H4). Die Cross-Modell-Erweiterung lieferte ein neues Ergebnis — ein quantitativ beschreibbarer Drift der Stundenglas-Form über Architekturgenerationen: vom frühen Flaschenhals zu zentrierten Stundengläsern mit Verschmelzung komprimierter Schichten und weiter.
Ausgangspunkt: Warum Geometrie Gewichte nicht komprimiert
Damit dieser Artikel als Fortsetzung lesbar ist, fixe ich, was aus der früheren Studie (CHMC v1→v6, results_v6/) bereits bekannt ist.
Wir haben versucht, die konische Geometrie der Aktivierungen auf die Kompression der Gewichte selbst anzuwenden: gewichtete SVD entlang des Kegels, adaptive Ränge, Kovarianzkorrekturen. Der Weg vom Kollaps (Ratio 4894× bei v1) bis zur Parität (~1.18× bei v6 bei gleichem Bit-Budget BPW = 4.2875 — exakt GPTQs Budget). Ergebnis auf drei Modellen: SmolLM — Parität mit GPTQ (Mittelwert 1.179–1.186 gegen 1.176), Qwen2.5-0.5B — Niederlage (einzelner Lauf, 1.174 gegen 1.141), TinyLlama-1.1B — ein echter Sieg von mehr als 30σ (1.059 gegen 1.081).
Alle geometrischen Techniken auf Gewichten schlugen fehl: Hadamard-Rotation — Ratio 2.23×, Lloyd-Max — 1.35× bei Baseline 1.21×, Cone-Aware — 2.15×, QJL — PPL 267/228 (theoretische Fehlergrenze √(1−1/4) ≈ 87%). Der einzige funktionierende Hebel — Dampening der Hessian-Schätzung (λ=0.05, −4%), d. h. Rauschkontrolle statt Geometrie-Erfassung. Über das Ensemble aus 124 Experimenten ist der einzige Flag mit positiver Korrelation zum Erfolg — Dampening (+0.40); alle geometrischen Flags sind nahe null oder negativ. Die nieder-rangige Drift-Korrektur wurde nach vorab deklariertem Kriterium widerlegt: d90 der Drift = 227–792 statt erwarteter <50.
Die spektralen Schlüsselfakten, die dieser Artikel architektonisch erklärt: Aktivierungen — schmaler Kegel (d90 ≈ 9 von 576 Dimensionen bei SmolLM, mittlerer Kosinus ≈ 0.75; in mittleren Blöcken liegen bis zu 98.9% der Varianz in drei Hauptkomponenten gegen 13–43% an den Rändern), Gewichte — dicht (minimale effektive Rang 29–30, Median ~60). Die Frage, die wir hier stellen: woher kommt diese Asymmetrie? Wäre sie eine Eigenschaft der Daten oder der Funktion, müsste geometrische Gewichtskompression funktionieren. Sie funktioniert nicht — also liegt die Quelle in der Modellarchitektur, und der Hauptkandidat auf Architekturebene ist Weight Tying.
Teil 1. Philosophie des Stundenglases
Arbeits-Metapher
Stellen Sie sich einen Transformer als dynamisches System vor: Eingabe-Embedding → L Transformator-Blöcke → Ausgabe-lm_head. Wenn wir die „Dimensionalität" der Daten an jedem Schritt darstellen, erwarten wir ein Muster: schmal (Embeddings im Kegel) → breit (Information wird in voller Dimensionalität verarbeitet) → schmal (Ausgabe wieder im Kegel). Das sind die Stundengläser.
Wichtig: Dies ist keine statische Struktur der Gewichte, sondern ein Muster der Repräsentationen beim Durchlauf der Daten. Die Gewichte können überall vollrangig sein, während Repräsentationen an den Rändern niedrigerdimensional und in der Mitte hoherdimensional sind. Das Stundenglas ist eine Eigenschaft der Funktion, nicht der Parameter.
Warum dies besser als „Superposition" ist
Die Literatur zur mechanistischen Interpretierbarkeit kennt das Konzept „Superposition": Ein Modell packt mehr Konzepte als Dimensionen, indem es Richtungen überlappt. Das erklärt, warum Gewichte dicht und vollrangig sind. Aber Superposition ist ein statisches Modell: Es sagt aus, was in den Gewichtsmatrizen kodiert ist.
Das Stundenglas ist ein dynamisches Modell: Es sagt aus, wie Daten durch das Netz fließen. Es erklärt nicht nur die Dichte der Gewichte (das Gesetz muss vollständig sein, um die Trajektorie zu halten), sondern auch die Niederdimensionalität der Aktivierungen (die Trajektorie liegt auf einem Attraktor) und die lineare Fehlerakkumulation bei Quantisierung (gestörte Dynamik lenkt die Trajektorie ab, aber der Attraktor zieht sie zurück — Divergenz ist linear, nicht exponentiell). Ein einziges dynamisches Bild erklärt alle drei Beobachtungen; statische Superposition — nur die erste.
Das Gedächtnis-Paradoxon
Wenn Repräsentationen auf niedrige Dimensionalität komprimiert sind, wie erinnert sich das Modell an einen langen Kontext? Der KV-Cache speichert Schlüssel und Werte in voller (oder fast voller) Dimensionalität — das Gedächtnis wird nicht so aggressiv komprimiert wie die Berechnungszustände. Dies sagt voraus: Wenn der Kontext wächst, muss der Druck auf niederdimensionale Repräsentationen wachsen, weil Informationen aus allen Positionen „durch" die schmale Taille des Stundenglases hindurchmüssen. Wenn das Modell das schafft — dann ist entweder die Taille breit genug oder das Gedächtnis umgeht sie. Das werden wir in H4 prüfen.
Teil 2. Daten und Protokolle
Modelle
Sechs lokale Base-Modelle aus drei Familien (Llama/Qwen/Gemma), alle auf physischem GPU 1 gemessen (cuda:1 hartkodiert in den Skripten); fp32 wo der Speicher reicht (VRAM 15.93 GiB), sonst bf16. Bei Gemma — isolierte Umgebung .venv-gemma4 (transformers 5.17.0), da ihre Architektur mit dem transformers-Paket der übrigen Modelle inkompatibel ist; das vision-Modul wurde von allen Messungen ausgeschlossen.
| Modell | Architektur | Parameter (exakt) | hidden | Schichten | Tying? | Vocab | max_pos |
|---|---|---|---|---|---|---|---|
| smollm-135m | LlamaForCausalLM | 134,515,008 | 576 | 30 | ja | 49,152 | 2,048 |
| qwen2.5-0.5b | Qwen2ForCausalLM | 494,032,768 | 896 | 24 | ja | 151,936 | 32,768 |
| tinyllama-1.1b | LlamaForCausalLM | 1,100,048,384 | 2048 | 22 | nein | 32,000 | 2,048 |
| qwen2.5-3b | Qwen2ForCausalLM | 3,085,938,688 | 2048 | 36 | ja | 151,936 | 32,768 |
| qwen3-4b | Qwen3ForCausalLM | 4,022,468,096 | 2560 | 36 | ja | 151,936 | 40,960 |
| gemma-4-e2b | Gemma4ForConditionalGeneration | 5,123,178,979 | 1536 | 35 | ja | 262,144 | 131,072 |
Kontrollpaar: Qwen2.5-0.5B (tied) und TinyLlama-1.1B (untied) — das einzige Modell in der Auswahl ohne Weight Tying; bei ihm sind die Eingabematrix (wte) und die Ausgabematrix (lm_head) getrennt, was es erlaubt, H1 „vor" und „nach" dem Regularisierer zu messen.
Korpus: 4 markdown-Dokumente des Projekts cmq_experiment (README.md, PROJECT.md, FINAL_REPORT_v4.md, report.md). Token-Pool: bis 8599 (Qwen-Tokenizer) / ~10080–10082 (Llama-Familie); die Größenunterschied im Pool — unterschiedliche BPE-Wörterbücher schneiden denselben Text in eine andere Anzahl von Stücken. Das gesamte Korpus passt in den Kontext der Modelle mit max_pos ≥ 32k; bei SmolLM und TinyLlama (max_pos = 2048) wurde ein Korpus-Fenster verwendet — daher ihre Länge L=2048 in Exp6.
Messprotokolle
- Exp7/H1. 128 Tokens. G_total — backward der eingebauten CE-Loss. G_in — eingefrorener Klon von lm_head, backward von CE über den Eingangspfad (nur Embeddings werden aktualisiert). G_out — no_grad versteckte Zustände + frische Kopie W', manuelle CE mit HF-Shift (nur die Ausgabematrix wird aktualisiert). Bei untied-Modellen werden beide Gradienten in einem einzigen backward genommen. Proxy: Für je 128 Tokens wird der Kosinus zwischen der qkv0-Störung aus dem Embedding-Update und der Störung aus dem Gewicht-Update berechnet — direkte Maß des Konflikts auf den gemeinsamen Gewichten.
- Exp5/H2. Für jede Schicht (Ebenen 0..L, wobei Ebene 0 = Embeddings) wird ein Kontext von 2048 Tokens genommen, die versteckten Zustände werden zentriert, exakte SVD; PR = Anzahl der Hauptkomponenten für 90% Varianz. Halsstelle = Argminimierung des zentrierten Profils (PRc). Anisotropie — mittlerer Kosinus zwischen Vektorpaaren der Schicht (raw und centered).
- Exp3/H3. Exakte SVD der gate_proj-Gewichte an der Halsstelle und der eingehenden Aktivierungen; k95(Gewichte) gegen k95(Aktivierungen), Energie der Top-10/Top-3 Singulär-Richtungen.
- E4b (H4, Geometrie).
E_DC = N·‖x̄‖²/Σ‖vᵢ‖²— Anteil der DC-Energie (gemeinsame Richtung) in den Last-Layer-Zuständen; zwei Bedingungen:prefix(zusammenhängendes Korpus) vsmixed(vermischte Blöcke zu 256 Tokens), N ∈ {100, 1000, 4096, 8192}, ein Modell A. - E4e/E4f (H4, Funktion). Pattern-Completion-Zonde am Modell A: Ein eindeutiger Code (
KZVX-9281+ 2 Analogons) wird in den Kontext an Position p eingebettet; lift = Δlogit(zieltoken vs. Alternative) minus Kontrolllauf ohne Nadel. E4e — nach Länge (L ∈ {100, 500, 1000, 2048, 4096, 8192}); E4f — nach Position: L ∈ {2048, 4096, 8192} × p = 0.05…0.95 (Schritt 0.1) × 3 Replikationen → 90 Zellen + 9 Kontrollen. - Exp6 (Cross-Modell). Per-Position-Lift an allen sechs Modellen, Positionen [0.05, 0.25, 0.45, 0.75, 0.95], 2 Replikationen/Zelle; Inversion Contrast = Mean Lift(Mitte) − Mean Lift(Ränder); > 0 → inverted-U, < 0 → klassische U / LiM-Richtung.
Alle Ergebnisse in _work/exp{5,6,7}_metrics.json, cross_model_results.json und _work/neck_zone_stats.json; Übersichtstabellen — in SUMMARY.md.
Teil 3. Ergebnisse
Hypothese 1 — Gradienteninterferenz als Tyrannei des Ausgabepfads
#### Methode
Für jedes Modell nehmen wir einen einzigen Lauf auf 128 Tokens. G_total wird durch backward der eingebauten CE-Loss berechnet (alle Parameter werden aktualisiert). Dann zwei „getrennte" Gradienten: G_in — mit eingefrorenem Klon von lm_head, so dass nur die Eingabe-Embeddings aktualisiert werden; G_out — mit no_grad versteckten Zuständen und frischer Kopie W', manuelle CE mit standard HF-Verschiebung, so dass nur die Ausgabematrix aktualisiert wird. Der Kosinus zwischen G_in und G_out misst die Opposition: Wenn sich die Pfade auf der gemeinsamen Matrix konfrontieren, muss der Kosinus deutlich negativ sein. Proxy-Maß: Für jeden der 128 Tokens berechnen wir die Störung des ersten qkv0-Zustands aus dem Embedding-Update (G_in) und aus dem Gewicht-Update von lm_head (G_out), nehmen den mittleren Kosinus-Abstand — eine direkte Maß dafür, wie unterschiedliche Richtungen im Repräsentationsraum die gemeinsamen Gewichte ziehen.
#### Kontrollpaar (originaler Exp1)
| Metrik | Tied Qwen-0.5B (A) | Untied TinyLlama-1.1b (B) |
|---|---|---|
| cos(G_in, G_out) auf der gemeinsamen W | +0.018 (orthogonal) | n/a (separate Matrizen: cos(G_emb, G_lm) = +0.0013) |
| Norm-Verhältnis out/in (lm/emb) | 3.754 | 0.998 |
| cos(G_total, G_out) | 0.967 — Ausgabepfad absorbiert das vollständige Update | — |
| Proxy: Einfluss des emb-Updates auf qkv_L0 | +0.007 | +0.002 |
Beim tied-Modell dominiert der Ausgabepfad die Norm um den Faktor 3.754, und G_total stimmt fast mit ihm überein (cos = 0.967): Der Gradient der Eingaberolle ist „unterdrückt". Beim untied-Modell sind die Normen balanciert (Verhältnis 0.998) und die Pfade orthogonal (cos +0.0013): Separate Matrizen interferieren ebenfalls nicht. Der Proxy-Konflikt ist in beiden Fällen vernachlässigbar klein (≤ 0.007): Die gemeinsamen Gewichte werden nicht „in beide Richtungen zerissen".
!
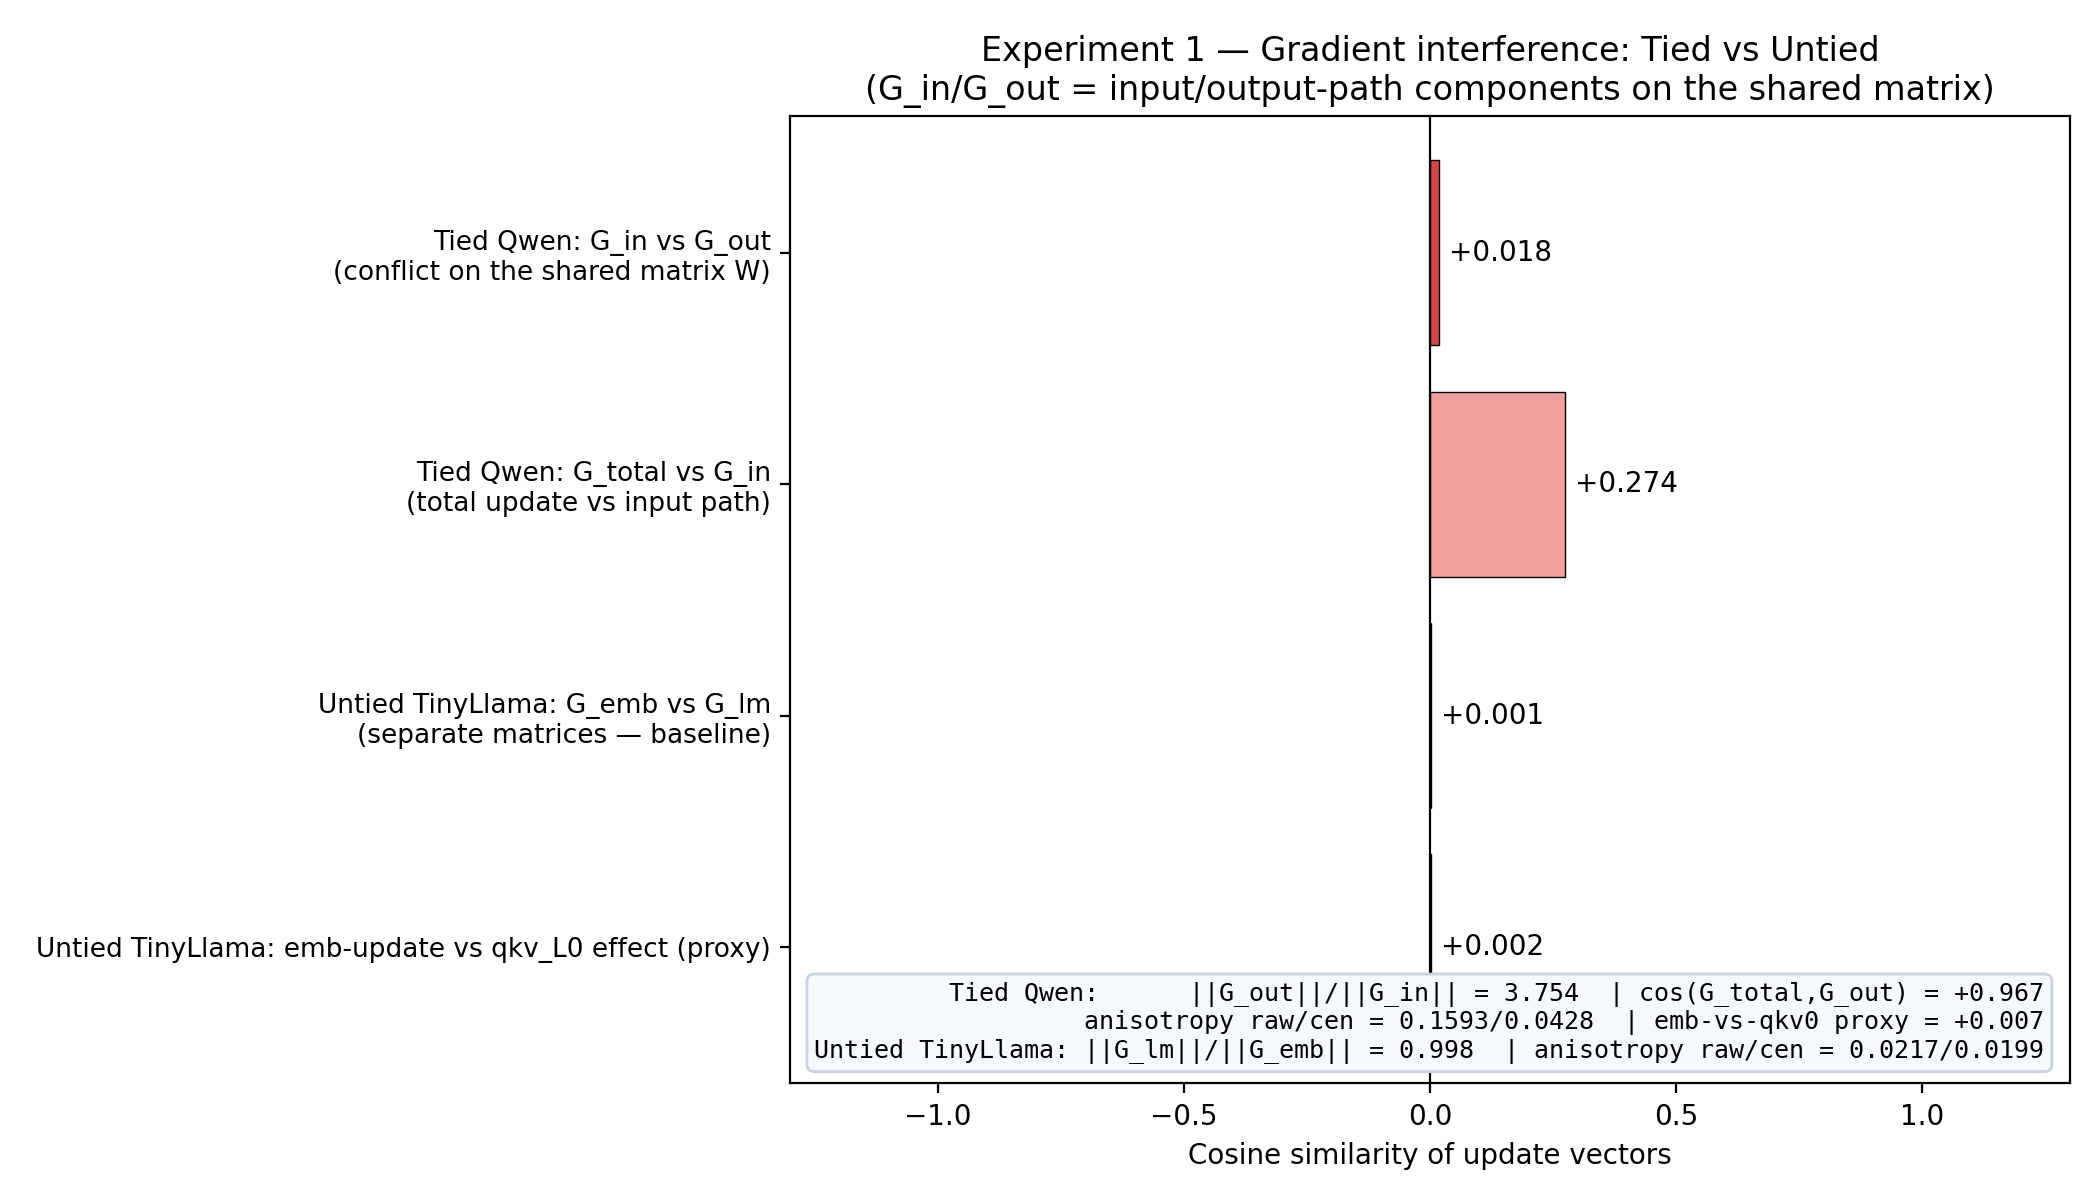
Abbildung 1. Gradientennormen und Kosinus von G_in/G_out auf der gemeinsamen Matrix: Qwen2.5-0.5B (tied, Ausgabe dominiert ×3.754) und TinyLlama-1.1b (untied, balanciert, orthogonal).
#### Cross-Modell Exp7: sechs Modelle
| Modell | Tying? | cos(G_in,G_out) / cos(G_emb,G_lm) | ‖G_out‖/‖G_in‖ | Dominanter Pfad | Proxy emb→qkv0 |
|---|---|---|---|---|---|
| smollm-135m | ja | +0.0155 | 4.416 | Ausgabepfad (cos(G_total,G_out) ≥ 0.967) | +0.0014 |
| qwen2.5-0.5b | ja | +0.0183 (orig. exp1: +0.018) | 3.754 (orig.: 3.754) | Ausgabepfad | +0.0073 (orig.: +0.007) |
| tinyllama-1.1b (untied) | nein | +0.0013 (cos G_emb,G_lm) | 0.998 (balanciert) | — | +0.0022 |
| qwen2.5-3b | ja | −0.0061 | 6.953 | Ausgabepfad | +0.1748 |
| qwen3-4b | ja | −0.0036 | 5.496 | Ausgabepfad | +0.2231 |
| gemma-4-e2b | ja | +0.0229 | 0.021 — Inversion (Eingang dominiert) | Eingangspfad: ‖G_in‖ = 664 vs ‖G_out‖ = 13.97, cos(G_total,G_in) = 0.9997 | +0.1197 |
Drei Beobachtungen.
Erste: Überall gibt es keine Opposition. Die Kosinus von G_in/G_out liegen im Bereich [−0.006, +0.023] — das ist Orthogonalität innerhalb des Rauschens. Die Hypothese „Der Eingangspfad zieht die Embeddings gegen den Ausgabepfad" wird in allen sechs Fällen widerlegt: Die Gradienten der beiden Pfade konfrontieren sich nicht; sie sind nahezu senkrecht zueinander. Interferenz auf der gemeinsamen Matrix ist kein Kampf, sondern Koexistenz.
Zweite: Die Interferenz erscheint als Dominanz. In vier von fünf tied-Modellen dominiert der Ausgabepfad die Norm um ×3.75–6.95, und G_total ist nahezu identisch mit ihm (cos(G_total,G_out) ≥ 0.967). Wir nennen das „die Tyrannei des Ausgangs": Der gemeinsame Regularisierer schafft keinen Konflikt — er macht einen der beiden Pfade für die gemeinsame Matrix unwesentlich. Dieselbe Richtung liefert eine Vorhersage, die H2 bestätigt: Wenn der Ausgabepfad die gemeinsame Matrix diktieren lässt, wird der Embedding-Raum für Dekodierung (Ausgang) optimiert und nicht für Kodierung — daher seine Kegelförmigkeit.
Dritte: Bei Gemma-4 ist das Bild invertiert. ‖G_in‖ = 664 gegen ‖G_out‖ = 13.97, cos(G_total,G_in) = 0.9997 — der Eingangspfad dominiert. Zwei ehrliche Einschränkungen. Erstens hängt die Gradientennorm einer Matrix von ihrer Größe ab (beim Gemma ist das Embedding 1536×262144 — das größte in der Auswahl), daher werden Kreuz-Verhältnisse der Normen nicht direkt verglichen; vergleichbar ist nur die Richtung der Dominanz innerhalb eines Modells. Zweitens läuft bei Gemma4 der Ausgang des Embeddings durch Skalierung (Wrapper-Klasse Gemma4TextScaledWordEmbedding): Der Gradient des Eingangspfads wird durch diesen Multiplikator differenziert, und bei großem Maßstab wächst ‖G_in‖ proportional zu ihm. Das ist die natürliche Erklärung der Inversion: nicht „Eingang übertönt Ausgang", sondern die Skalierung des Embeddings verstärkt den Eingangsgradienten — eine Interpretation, die durch Lesen des Skalenfaktors aus dem Modellcode prüfbar ist. Nach unserem Wissen ist dies die erste dokumentierte Beobachtung einer Dominanzinversion auf einer gemeinsamen Matrix: In der Literatur zu tied-Decodeern wird „die Tyrannei des Ausgangs" diskutiert; ihre Inversion wird in keiner Quelle berichtet — das Regime erfordert eine separate Untersuchung.
Proxy-Trend. Der Proxy-Konflikt wächst mit der Modellgröße: 0.0014 (SmolLM) → 0.0073 (Qwen0.5B) → 0.2231 (Qwen3-4B), und beim untied TinyLlama ist er minimal unter den großen Modellen (0.0022). Die Richtung stimmt mit der Erwartung überein: Je größer das Modell, desto stärker „divergieren" Eingangspfad und Ausgabepfad im Repräsentationsraum — aber selbst das Maximum 0.22 ist weit vom Konflikt entfernt; dies ist eine moderate Divergenz der Richtungen, keine Opposition.
!
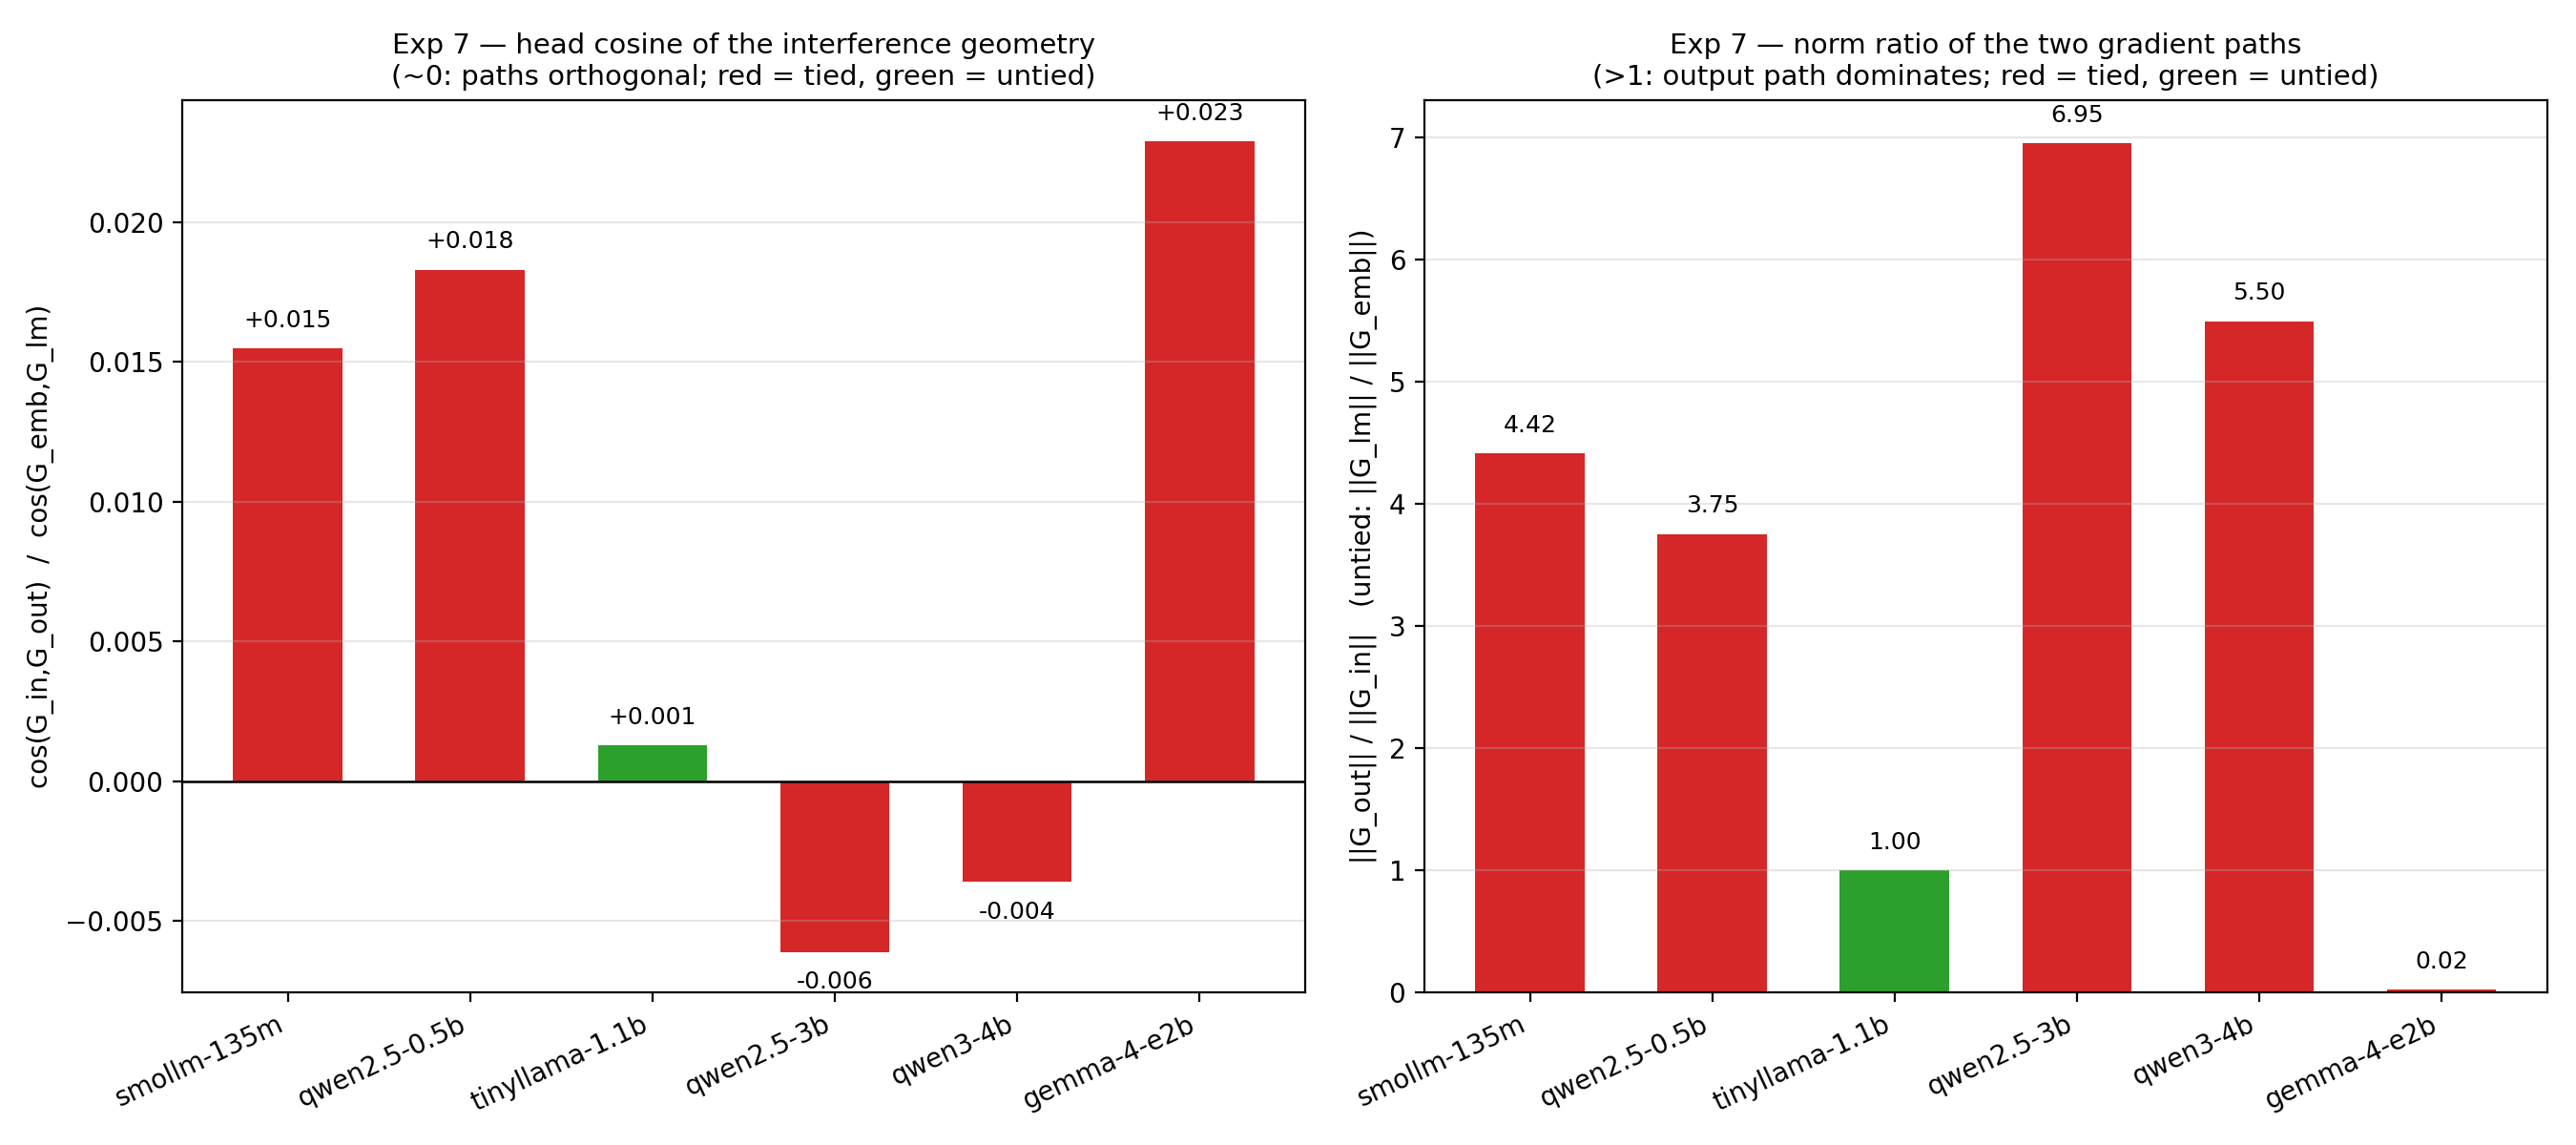
Abbildung 2. Eingangs-/Ausgangs-Gradientennormen und Kosinus über sechs Modelle (Exp7): Ausgabedominiert bei vier tied-Modellen, Inversion bei Gemma-4.
!
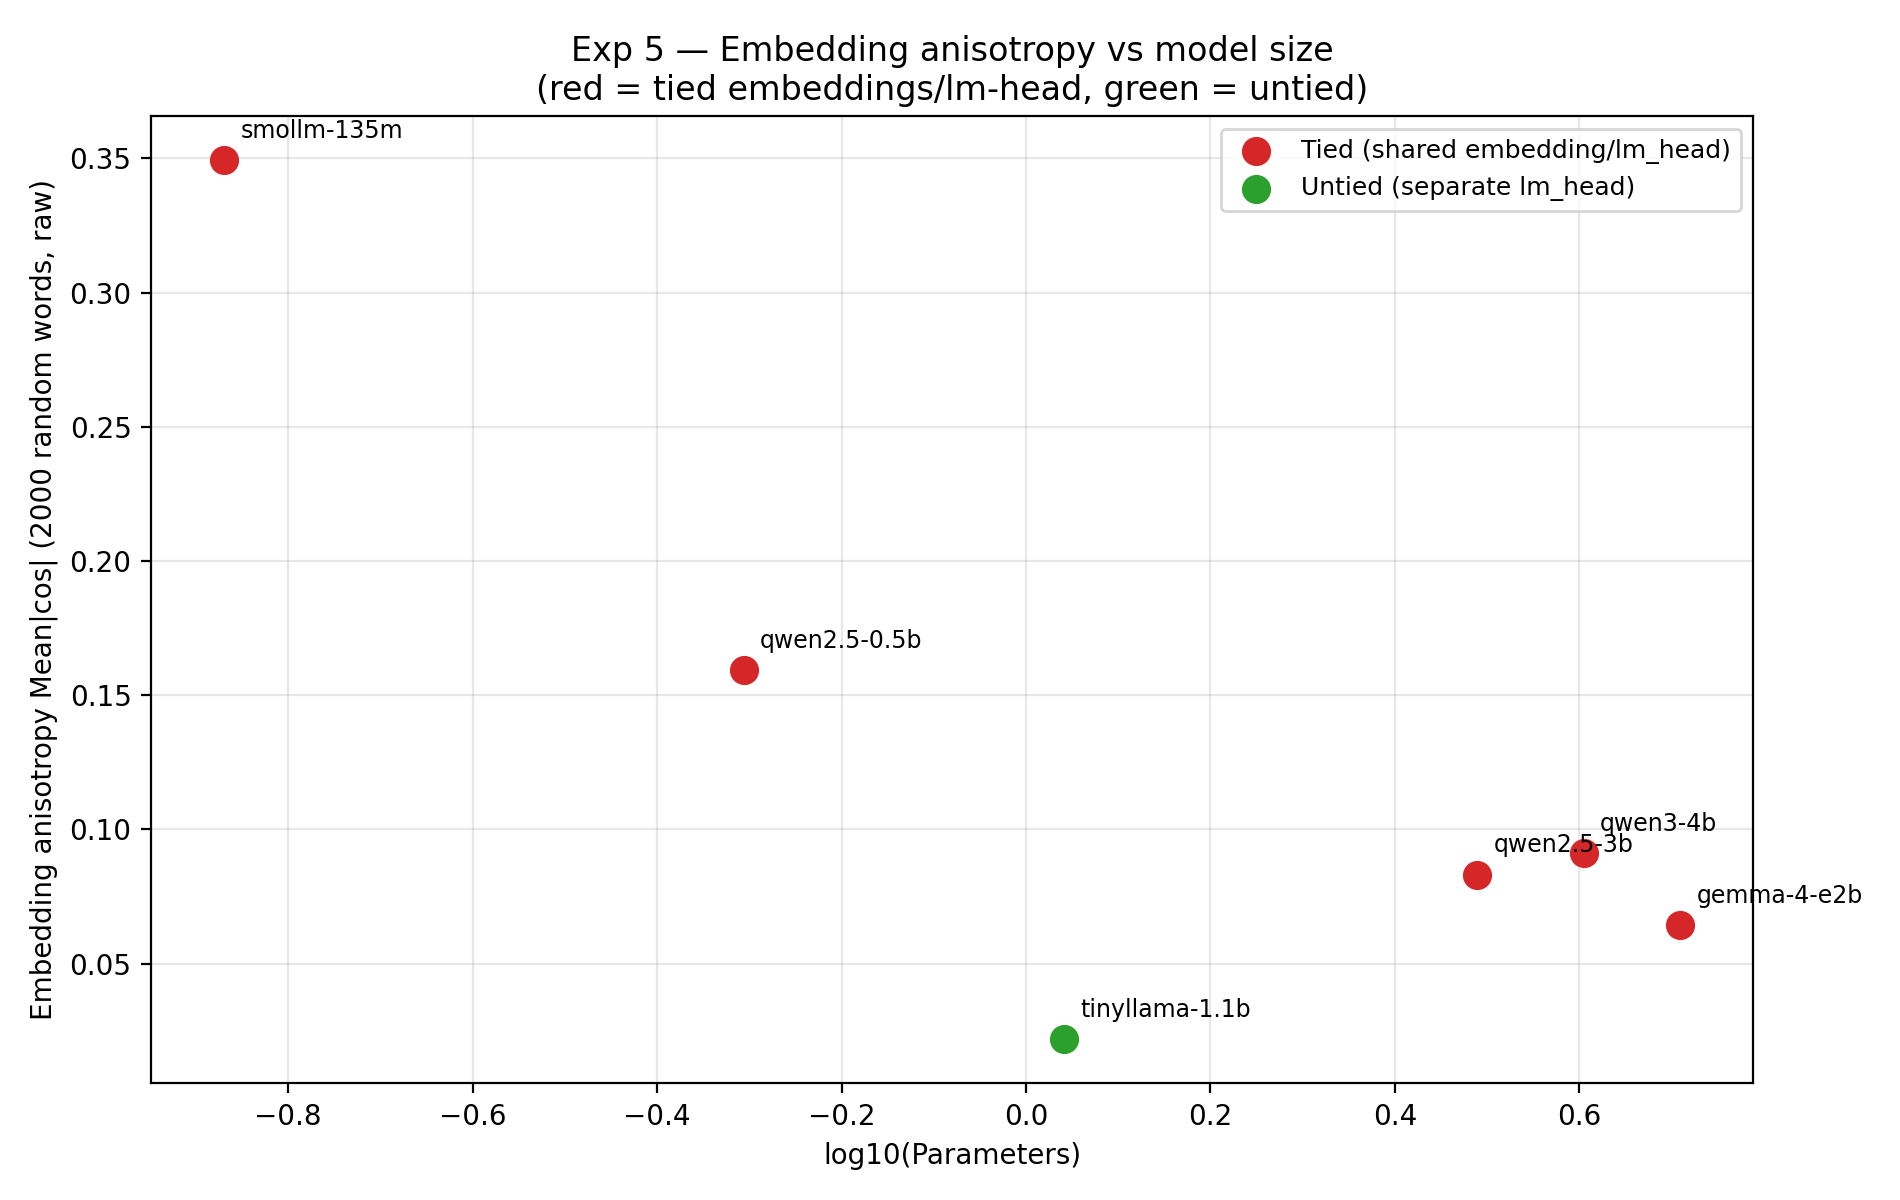
Abbildung 3. Anisotropie des Embedding-Raums (raw und centered) in Abhängigkeit von der Größe: tied-Modelle sind zu einem Kegel verformt, das einzige untied TinyLlama — minimale Anisotropie.
#### Urteil H1:TEILBESTÄTIGT IN ANOMALER FORM — wird an allen sechs Modellen reproduziert
Weight Tying funktioniert tatsächlich als Regularisierer, aber der Mechanismus ist nicht „Gradienten-Opposition", sondern die Dominanz eines Pfads: Der gemeinsame Ausgabepfad bestimmt die Embedding-Matrix (cos(G_total,G_out) ≥ 0.967 bei vier von fünf tied-Modellen), der Eingangspfad ist marginal. Der Proxy-Konflikt ist überall klein, wächst aber monoton mit der Modellgröße und ist beim untied TinyLlama minimal — die Richtung stimmt mit der Hypothese überein. Bei Gemma-4 ist die Dominanz auf den Eingangspfad invertiert (Embedding-Skalierung); das bricht das Bild nicht, sondern verfeinert es: Der Regularisierer wählt immer einen Sieger, aber der Sieger hängt von der Architektur ab.
Hypothese 2 — Universelles Stundenglas und seine Generationendrift
#### Methode
Für jedes Stack-Level (0 = Embeddings, 1..L = Transformer-Blöcke) nehmen wir einen Kontext von 2048 Tokenen, zentrieren die versteckten Zustände nach dem Mittelwert und führen eine exakte SVD durch. PR — Anzahl der Hauptkomponenten, die 90% der Varianz erklären (raw); PRc — dasselbe für zentrierte Zustände. Die Halsstelle des Stundenglases = Level mit minimalem PRc. Zusätzlich berechnen wir die Anisotropie der Schicht — mittlerer Kosinus zwischen Vektorpaaren (raw und centered).
#### Kontrollpaar (originaler Exp2)
| Metrik | Tied Qwen-0.5B (A) | Untied TinyLlama-1.1b (B) |
|---|---|---|
| PR(L0) — Embeddings | 25.88 | 155.83 |
| PR Mittelstufe (L12 / L11) | 1.37 | 2.12 |
| PR letzte Schicht | 7.64 | 30.36 |
| Halsstelle (min zentriertes PR) | L4, PR = 1.17 | L3, PR = 1.13 |
Beide Modelle ergeben wide–narrow–wide: breites Eingangsende, enge Halsstelle (PR ≈ 1.2 — praktisch Rang 1), breiteres Ausgangsende. Das TZ-Kriterium — „die Form ähnelt einem Stundenglas" (Symmetrie nicht erforderlich) — beide Modelle bestehen es. Die festgehaltene Asymmetrie (Einschränkung): Kollaps an der Eingangsrandseite (L3–L4), dann ein langes niedriges Plateau und Wiederherstellung nur in den letzten ~5 Schichten — Qwen: Roh-PR-Peaks ≈91 @ L1, ≈68 @ L22–23; TinyLlama: monotoner Anstieg bis 57 @ L21. Die Halsstelle ist bei tied und untied nahezu identisch (1.17 vs 1.13) → der niedrigdimensionale Attraktor ist eine Eigenschaft kleiner LLMs in diesem Kontext, nicht spezifisch für Tying. Das ist bereits ein Hinweis darauf, dass die Form des Stundenglases von der Architektur abhängt und nicht nur vom Weight Tying.
!
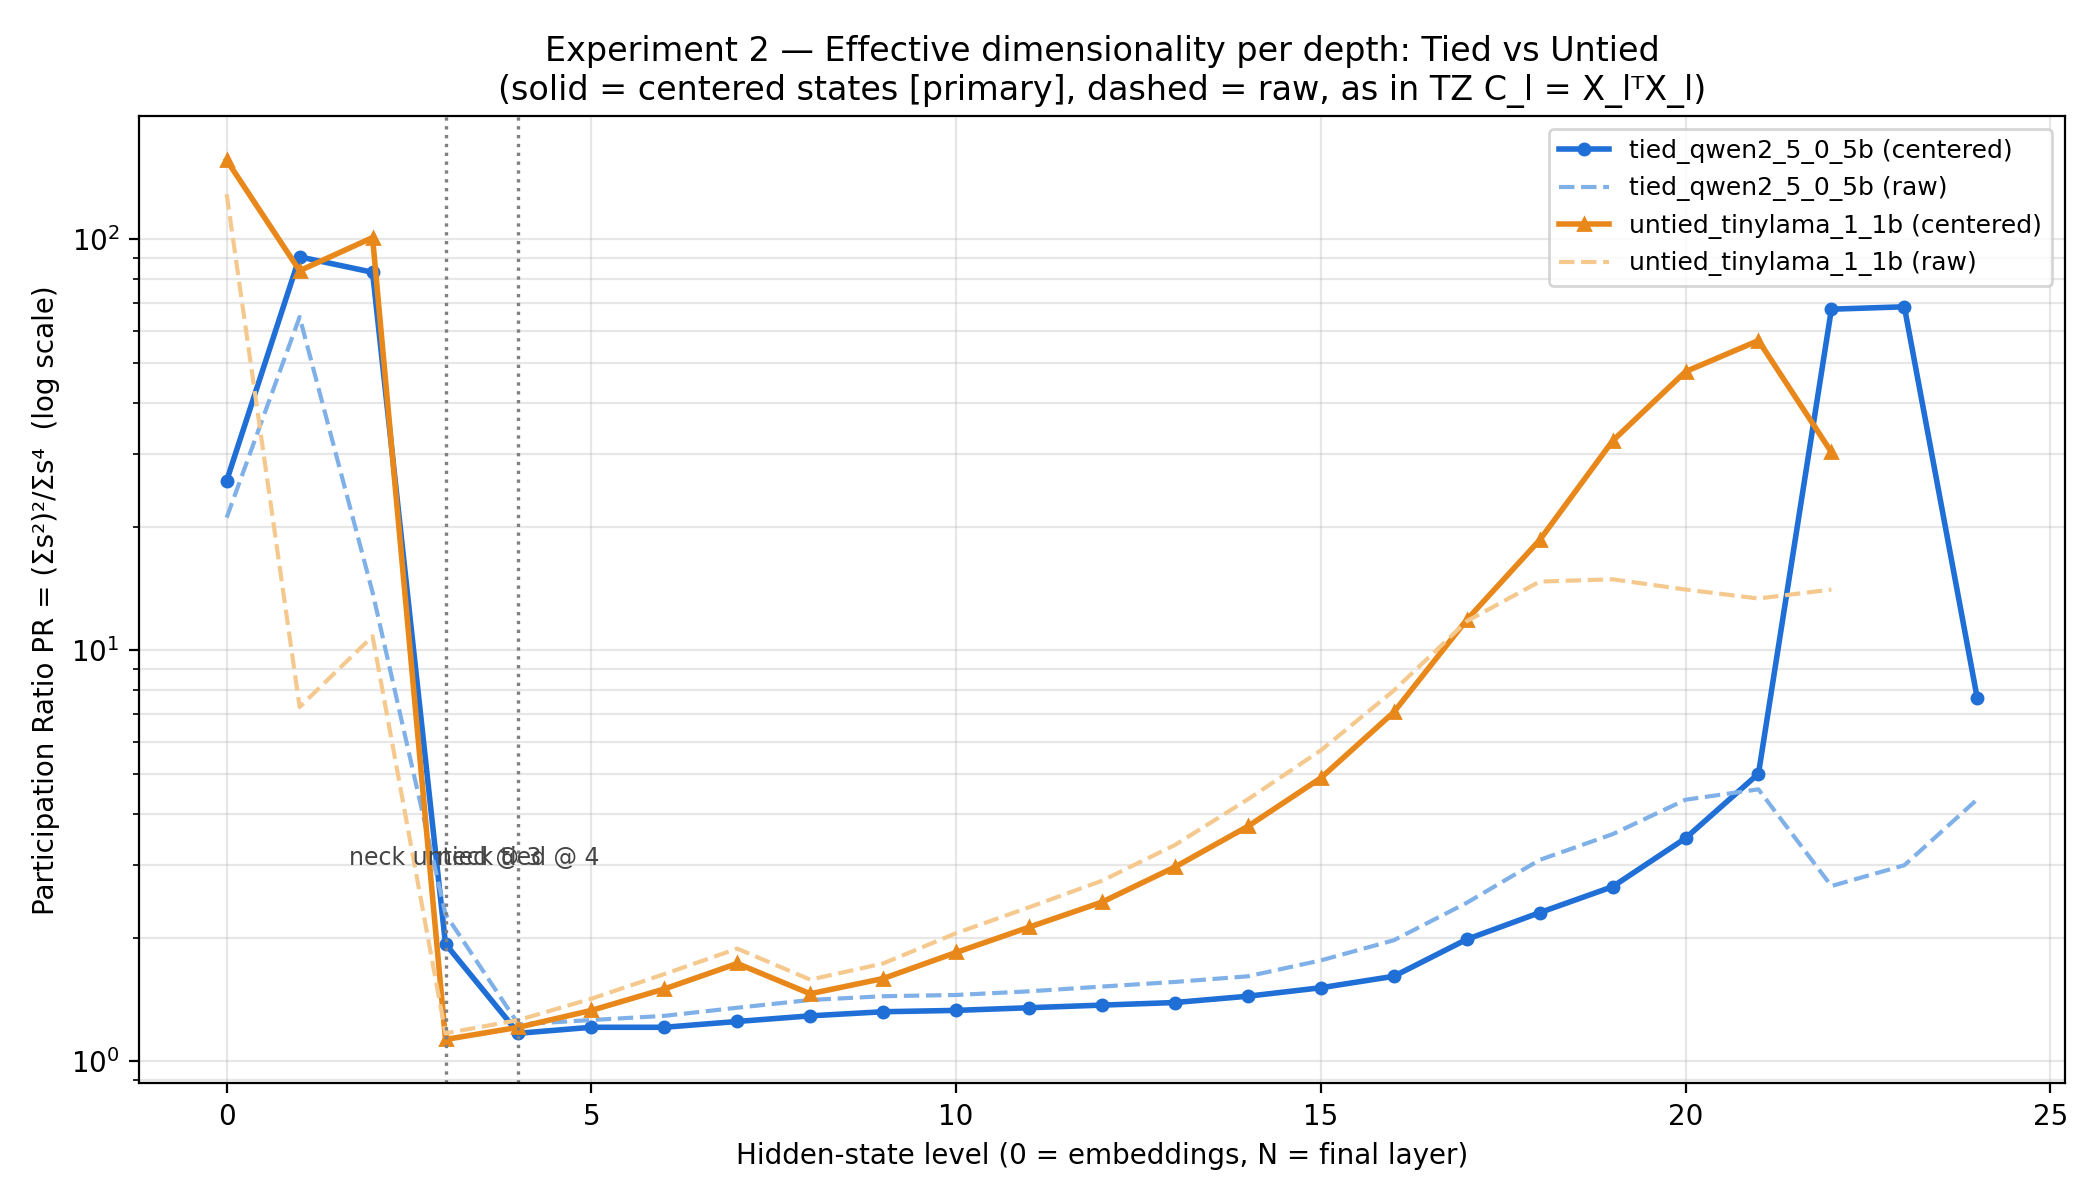
Abbildung 4. Principal-Rank-Profile über den Stack: Qwen2.5-0.5B (tied) und TinyLlama-1.1b (untied): wide–narrow–wide, Halsstelle L4 (PR 1.17) / L3 (PR 1.13), Asymmetrie — Kollaps an der Eingangsrandseite und Wiederherstellung in den letzten Schichten.
#### Halsstellen in sechs Modellen (Exp5)
| Modell | L | Halsstelle (Level) | Tiefe der Halsstelle | PRc(Halsstelle) |
|---|---|---|---|---|
| smollm-135m | 30 | L12 | 40% | 1.08 |
| qwen2.5-0.5b | 24 | L4 | 17% | 1.17 |
| tinyllama-1.1b | 22 | L3 | 14% | 1.13 |
| qwen2.5-3b | 36 | L3 | 8% | 1.10 |
| qwen3-4b | 36 | L17 (Mittel des Stacks) | 47% | 1.13 |
| gemma-4-e2b | 35 | L35 (letzter Block vor lm_head) | kein Mid-Stack | 6.00 |
Bei Gemma bleibt das zentrierte PR in allen Schichten hoch (≈ 33–122) und fällt nur auf dem letzten Level auf 6.0: einen Mid-Stack-Kollaps gibt es nicht; ihr „Flaschenhals" liegt am Ausgangsrande und ist ~5× lockerer als die Halsstellen der übrigen Modelle (PR 6 vs ≈ 1.1).
Embedding-Anisotropie (raw / centered): smollm 0.349/0.059; qwen0.5b 0.159/0.043; tinyllama 0.022/0.020; qwen3b 0.083/0.021; qwen4b 0.091/0.019; gemma 0.064/0.027. Das einzige untied-Modell hat die minimale Anisotropie (0.022) — die Richtung stimmt mit H1 überein: ohne gemeinsamen Regularisierer wird der Embedding-Raum nicht so stark zu einem Kegel verformt wie bei tied-Modellen (auf der unausgewogenen Auswahl 5 tied / 1 untied ist dies eine Beobachtung, keine Statistik).
#### Kompressionszonen: vom Flaschenhals zur Schicht-Mischung
„Die Halsstelle" als einzelner Minumpunkt — ein grobes Modell. Wir haben die niedrigdimensionale Zone quantitativ beschrieben (cross_model/compute_zone_stats.py, _work/neck_zone_stats.json): n_low = Anzahl der Stack-Level 1..L mit PRc < T=2 (PR ≈ 2 bedeutet effektiven Rang nahe 2); Zone = längste zusammenhängende Folge sub-T-Levels, die die Halsstelle enthält; lokale Minima — interne Einbrüche des Profils unterhalb des Schwellwerts.
| Modell | n_low / L | Zone um die Halsstelle | Breite | Zonenstart (Anteil der Tiefe) | Lokale Minima <2 | Regime |
|---|---|---|---|---|---|---|
| smollm-135m | 14/30 (47%) | L12–L25 | 14 (47% der Tiefe) | 0.40 | {L12} | zentriertes Stundenglas |
| qwen2.5-0.5b | 15/24 (62%) | L3–L17 | 15 (62%) | 0.12 | {L4} | früher Trichter |
| tinyllama-1.1b | 8/22 (36%) | L3–L10 | 8 (36%) | 0.14 | {L3, L8} | früher Trichter, doppelte Taille |
| qwen2.5-3b | 22/36 (61%) | L3–L24 | 22 (61%) | 0.08 | {L3} | früher Trichter / langes Plateau |
| qwen3-4b | 20/36 (56%) | L7–L26 | 20 (56%) | 0.19 | {L7, L11, L17} | zentriertes Stundenglas, dreifache Taille |
| gemma-4-e2b | 0/35 (0%) | keine (<2); bei T=10: nur L35 (PRc 6.0) | — | 1.00 | {} | verteiltes Regime, Kompression am Ausgang |
Drei Regime und Generationendrift. Alte Generation (Qwen2.5 ×2, TinyLlama) baut die niedrigdimensionale Zone direkt am Eingang: Start bei 8–14% der Tiefe, asymmetrischer Trichter — „Flaschenhals" im klassischen Sinne. Bei TinyLlama gibt es innerhalb der Zone zwei Einbrüche (L3 und L8) — eine primitive vestigiale Form der Schicht-Mischung. Mittlere Generation (SmolLM) zentriert die Zone: Start 0.40, Breite 14 Schichten, einzelnes Minimum in der Mitte (L12). Die neue Generation spaltet sich in zwei Vektoren. Qwen3-4B — das am stärksten zentrierte Stundenglas der Auswahl (Breite 56% der Tiefe), aber seine Taille besteht aus drei komprimierten Minima L7/L11/L17: genau das ist die „Mischung komprimierter Schichten" — das Modell faltet die Information nicht in eine Halsstelle, sondern hält die Niedrigdimensionalität als breites Band mit innerer Struktur aufrecht, d.h. mehrere attraktive „Knoten" sind über den Stack verteilt. Gemma-4 geht jenseits des Stundenglases: mittlere Kompression gibt es überhaupt nicht (n_low = 0 beim strengen Schwellwert; PRc über den Stack 33–122), komprimiert wird nur der finale Block (PRc 6.0, fünfmal lockerer als die Halsstellen der übrigen Modelle). Wahrscheinlicher Mechanismus — sliding-window attention: 28 von 35 Schichten arbeiten mit einem Fenster von 512 Tokenen, und die Repräsentation braucht keine globale Kompression über den Stack, weil jede Schicht lokal ist; konzentriert wird nur der Ausgang. Das ist eine Interpretation, sie erfordert ein eigenes Experiment (Fenster-Ablation), aber quantitativ ist das Bild „Stundenglas → verteiltes Regime" festgehalten: der Zonenstart verschiebt sich von 0.08 zu 1.00 mit den neueren Architekturen. Diese Drift sagt Unterschiede in den Positionsprofilen des Recall zwischen Modellen voraus — die Verbindung wird vom cross-modell LiM-Scan (Exp6) unten geprüft.
Ehrliche Einschränkungen: n = 6 Modelle aus drei Familien, Kreuzvergleiche werden durch Größe und Architektur verwickelt; SmolLM — ein kleines Modell mit zentrierter Zone, sodass „neuer = zentrierter" nicht streng monoton in der Größe ist, sondern einen Generationstrend beschreibt (Qwen2.5 → Qwen3, Gemma). Dennoch ist die Form der Zonen an jedem Modell unabhängig von der Größe reproduzierbar: Bei allen fünf Standardmodellen deckt die Zone 36–62% der Stacktiefe ab — „das Stundenglas" ist kein Punkt, sondern eine ausgedehnte Struktur.
!
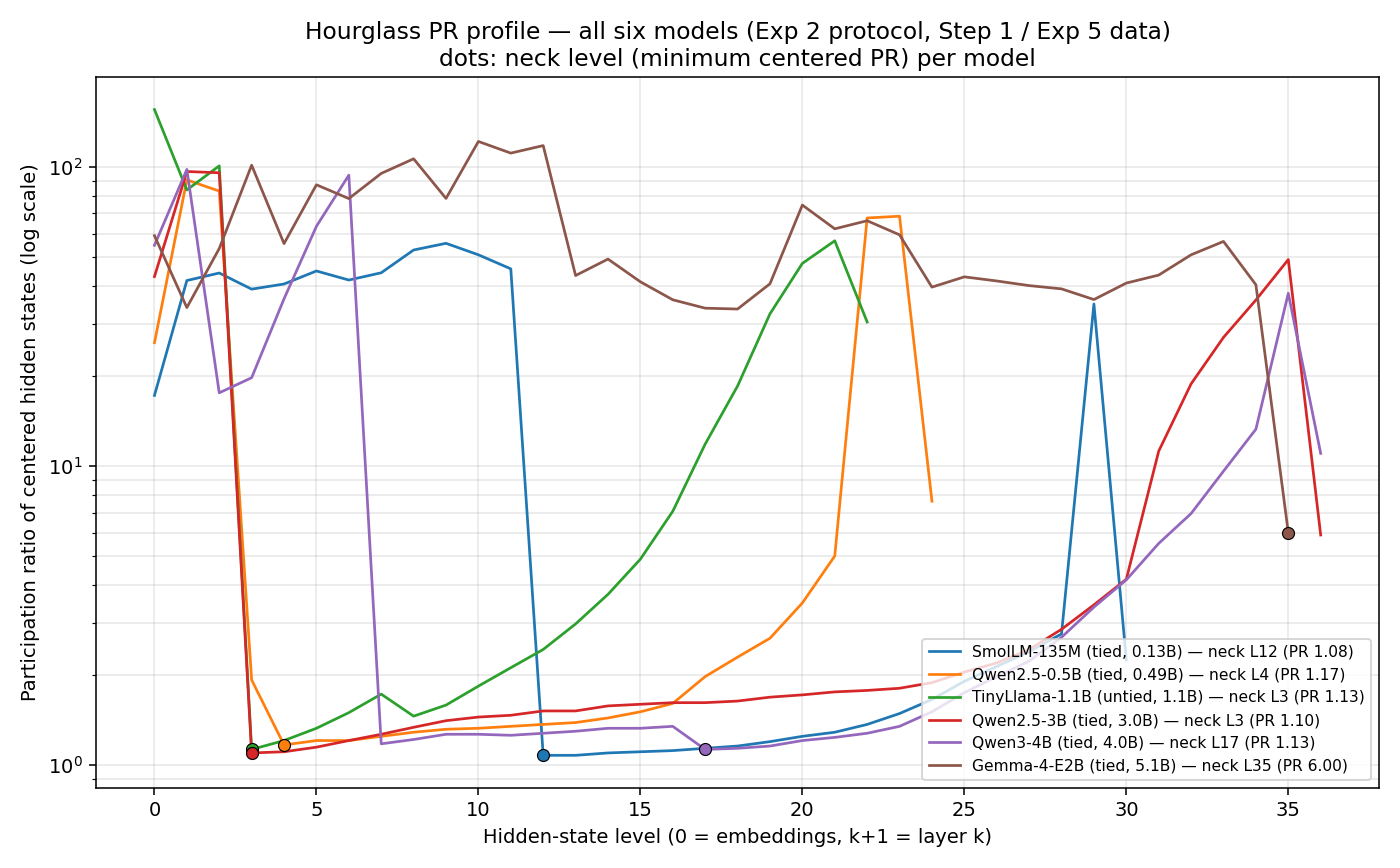
Abbildung 5. Vollständige PR-Profile der sechs Modelle auf einer Achse: Trichter von Qwen2.5/TinyLlama am Eingang, zentrierte Bänder von SmolLM und Qwen3-4B (dreifache Taille), flaches Profil von Gemma mit Kompression nur am Ausgang.
#### Urteil H2:BESTÄTIGT AN 5 VON 6 MODELLEN (Gemma — Ausnahme)
Alle fünf Standardmodelle zeigen eine niedrigdimensionale Zone im Stack mit PRc der Halsstelle ≈ 1.1–1.2; die Zonen decken bis zu 62% der Tiefe ab, und die Form der Zonen driftet über Generationen: früher Flaschenhals (Qwen2.5, TinyLlama) → zentriertes Stundenglas (SmolLM) → Stundenglas mit Mischung komprimierter Schichten in der Taille (Qwen3-4B: drei Minima L7/L11/L17) → verteiltes Regime ohne mittlere Halsstelle (Gemma-4, vermutlich — Folge des sliding-window attention). Die Universalität „eine Halsstelle in der Mitte" wird widerlegt; universell ist das Vorhandensein einer ausgedehnten niedrigdimensionalen Zone und ihre Verschiebung zum Ausgang / Verteilung in neueren Architekturen.
Hypothese 3 — Spektrale Asymmetrie: Gesetz vs. Trajektorie
#### Methode
An der Halsstelle des Stundenglases (L4 bei Qwen, L3 bei TinyLlama) führen wir eine exakte SVD der Gewichtsmatrix von gate_proj und ihrer eingehenden Aktivierungen durch. k95(X) = Anzahl der Singulärkomponenten, die 95% der Energie erklären; Top-10/Top-3-Energie — Anteil der Energie in den ersten Richtungen.
#### Kontrollpaar (originaler Exp3)
| Modell | Matrix | Dimension | k95(Gewichte) | k95(Aktivierungen) | Top-3-Aktivierungsenergie | Top-10-Gewichtsenergie |
|---|---|---|---|---|---|---|
| Qwen2.5-0.5B (tied) | gate_proj | 896×896 | 766/896 | 21/896 | 0.930 | 0.048 |
| TinyLlama-1.1b (untied) | gate_proj | 2048×2048 | 1610/2048 | 8/2048 | 0.944 | 0.056 |
Das Muster ist in beiden Modellen identisch, mit und ohne Tying: die Gewichte sind nahezu volles Rang (k95 ≈ 85–79% der Dimension), die Aktivierungen radikal niedrigdimensional (k95 = 21/896 ≈ 2.3%, 8/2048 ≈ 0.4%), während die Top-3-Richtungen 93–94% der Energie tragen und die Top-10-Gewichte — nur 5%. Weight Tying wird nicht benötigt, um diese Asymmetrie zu erzeugen: sie reproduziert sich auch im untied-Modell.