从《为什么几何不能压缩权重》到造就这一不对称性的架构。
日期:2026-09-16 · 作者:Millog · 许可证:CC BY-SA 4.0
数据与代码:cmq_experiment/tied_vs_untied/(实验 H1–H4、Exp5–7),cmq_experiment/results_v6/(量化研究)
摘要
我们检验如下假设:权重绑定(weight tying)——小型 LLM 的标准架构约束——充当隐式正则化器:共享输入/输出矩阵上的梯度干涉将嵌入空间变形为各向异性的锥,而网络通过在堆栈深处某处构建低维吸引子("动态沙漏")来补偿。我们在六个本地 base 模型(0.135B 至 5.12B 参数)上直接测量了这一点,其中包括 tied vs untied 对照对(Qwen2.5-0.5B 与 TinyLlama-1.1B),其中约束在一方被移除。
结果:(1) 不存在梯度对立——各路径处处正交(|cos| ≤ 0.023);干涉表现为单一路径的主导(6 个模型中 4 个出现"输出路径的暴政",Gemma 上反转至输入路径)。(2) 5/6 个模型确认沙漏结构;压缩区覆盖堆栈深度最多 62%——"颈部"不是单层而是一条宽带。(3) "定律 vs 轨迹"谱不对称性得到确认:满秩稠密权重对低维激活——这是先前研究中几何权重压缩失败的机制。(4) 跨模型分析显示低维区形状存在代际漂移:从输入端早期瓶颈(Qwen2.5、TinyLlama),经居中沙漏(SmolLM),到腰部压缩层混合(Qwen3-4B —— 三个极小值 L7/L11/L17),再到无中段压缩的分布式模式(Gemma-4,sliding-window attention)。(5) "质量压力"假设在至 8192 token 范围内被局部证伪:既未复现质量退化,也未复现 lost-in-the-middle——几何随上下文长度保持平坦。
引言
计算肉体与理解的幻觉
语言是"计算肉体"。要理解它的架构,必须停止问"模型在做什么?",转而问"它如何计算这件事?"。我们无法像查看程序代码那样窥视神经网络内部,但可以测量其内部状态。
本文是我先前研究《为什么几何不能压缩权重》(见 cmq_experiment/results_v6/)的续篇。那里我证明了 LLM 激活值位于狭窄的锥中:90% 的能量在 ~1–3 个主成分里,而权重是满秩且稠密的。所有几何权重压缩技术(Hadamard 旋转、Lloyd-Max、锥形分解、QJL)都得到零或负收益;唯一有效的杠杆——data-adaptive 误差补偿(GPTQ)。最终公式:权重 = 动力学定律,激活值 = 低维吸引子上的轨迹。
但主要问题仍然悬而未决:是什么造就了这一不对称性?为什么训练导致稠密权重与狭窄表示?我提出了一个架构起源的假设:绑定输入矩阵与输出矩阵是一个隐式正则化器,将嵌入空间变形为锥。如果这个锥存在,那么网络必须在深处某处把信息"压缩"到低维,并在输出端再"扩张"回来。这就是动态沙漏的意思:不是权重的静态结构,而是数据穿过模型时涌现的模式。
本文中我们检验四个假设,上述图景即从它们推出:
- H1 —— 梯度干涉。如果输入矩阵与输出矩阵是同一个,那么来自输入路径(embedding)和输出路径(lm_head)的梯度在共享矩阵上发生干涉。这造成优化冲突:输入路径把嵌入向量往一个方向拉,输出路径往另一个方向拉。结果是嵌入空间的各向异性变形。
- H2 —— 沙漏。如果空间在输入端被压缩(锥),那么网络中部某处必须发生"扩张"到满维以便模型处理信息,随后再为输出而"压缩"回去。这产生逐层的有效维度轮廓:窄 → 宽 → 窄。
- H3 —— 谱不对称。权重应当满秩(高有效维度),激活值低维(低有效维度)。这是 H1 与 H2 的直接推论:权重被编码为"定律"(稠密、经训练净化),而表示——是"吸引子上的轨迹"。
- H4 —— 质量压力。如果模型用低维表示来节省计算,那么随着上下文增长它应比满秩表示的模型退化得更厉害。这是把 "lost in the middle" 作为几何效应的预测:低维空间无法容纳长上下文所有位置的信息。
实验设计:每个假设都有直接测量(tied vs untied 对照对)和跨模型扩展(6 个模型,0.135B 至 5.12B)。结果:两个假设得到证实(H2 —— 在 6 个模型中的 5 个上、H3),一个以异常形式被证实(H1:不是梯度对立,而是单一路径的暴政),第四个被局部证伪(H4)。跨模型扩展给出了一个新结果——可以定量描述的沙漏形状随架构代际的漂移:从早期瓶颈到带压缩层混合的居中沙漏,再到更后的形态。
起点:为什么几何不能压缩权重
为了让本文作为续篇可读,我固定一下先前研究(CHMC v1→v6,results_v6/)中已知的结论。
我们曾试图把激活值的锥形几何应用到权重本身的压缩上:沿锥的加权 SVD、自适应秩、协方差校正。路径从崩溃(v1 时 ratio 4894×)走到对等(~1.18×,v6,在同等位预算 BPW = 4.2875 —— 正好是 GPTQ 的预算)。三个模型上的结果:SmolLM —— 与 GPTQ 对等(均值 1.179–1.186 vs 1.176),Qwen2.5-0.5B —— 败(单次运行,1.174 vs 1.141),TinyLlama-1.1B —— 一次超过 30σ 的真正胜利(1.059 vs 1.081)。
所有作用在权重上的几何技术都失败了:Hadamard 旋转——ratio 2.23×,Lloyd-Max——baseline 1.21× 下的 1.35×,Cone-Aware——2.15×,QJL——PPL 267/228(理论误差界 √(1−1/4) ≈ 87%)。唯一有效的杠杆——Hessian 估计的阻尼(λ=0.05,−4%),即噪声控制而非捕获几何。在 124 个实验的集合中,与成功正相关唯一的 flag —— 阻尼(+0.40);所有几何 flag 都在零附近或为负。低秩漂移校正按预先声明的标准被证伪:漂移的 d90 = 227–792,而非预期的 <50。
本文从架构上解释的关键谱事实:激活值——狭窄锥(SmolLM 中 d90 ≈ 576 维中的 9,平均余弦 ≈ 0.75;中部块最多 98.9% 的方差在三个主成分里 vs 两端 13–43%),权重——稠密(最小有效秩 29–30,中位数 ~60)。我们在本文提出的问题:这一不对称性从何而来?如果它是数据或函数的性质,几何权重压缩就应该有效。它无效——所以来源在模型架构里,而架构层面的主要候选是 weight tying(权重绑定)。
第一部分. 沙漏的哲学
工作隐喻
把一个 Transformer 想象成一个动力系统:输入 embedding → L 个 Transformer 块 → 输出 lm_head。如果我们在每一步表示数据的"维度",我们预期一个模式:窄(嵌入在锥中)→ 宽(信息在全维中被处理)→ 窄(输出回到锥中)。这就是沙漏。
重要:这不是权重的静态结构,而是数据穿过时表示的模式。权重可以处处满秩,但表示——在两端低维、在中部高维。沙漏是函数的性质,不是参数的性质。
为什么这比"叠加"更好
mechanistic interpretability(机制可解释性)文献中有"superposition(叠加)"概念:模型通过方向重叠把比维度更多的概念打包进去。这解释了权重为何稠密且满秩。但叠加是静态模型:它说的是权重矩阵里编码了什么。
沙漏是动态模型:它说的是数据如何流过网络。它不仅解释权重的稠密性(定律必须是完整的才能托住轨迹),还解释激活值的低维性(轨迹躺在吸引子上)以及量化时误差的线性累积(受扰动的动力学把轨迹偏折,但吸引子把它拉回——发散是线性的而非指数的)。一幅动态图景解释了全部三个观察;静态叠加只解释第一个。
记忆悖论
如果表示被压缩到低维,模型如何记住长上下文?KV-缓存以全(或接近全)维度存储键和值——记忆不像计算状态那样被激进地压缩。这预测:随着上下文增长,低维表示上的压力应当增长,因为所有位置的信息必须"穿过"沙漏的窄腰。如果模型扛得住——那么要么腰部足够宽,要么记忆绕过了它。我们将在 H4 中检验这一点。
第二部分. 数据与协议
模型
三个家族(Llama/Qwen/Gemma)的六个本地 base 模型,全部在物理 GPU 1 上测量(脚本中硬编码 cuda:1);fp32 在内存够的地方用(VRAM 15.93 GiB),否则 bf16。Gemma —— 隔离环境 .venv-gemma4(transformers 5.17.0),因为其架构与其他模型的 transformers 不兼容;vision 模块从所有测量中排除。
| 模型 | 架构 | 参数(精确) | hidden | 层数 | Tying? | Vocab | max_pos |
|---|---|---|---|---|---|---|---|
| smollm-135m | LlamaForCausalLM | 134,515,008 | 576 | 30 | 是 | 49,152 | 2,048 |
| qwen2.5-0.5b | Qwen2ForCausalLM | 494,032,768 | 896 | 24 | 是 | 151,936 | 32,768 |
| tinyllama-1.1b | LlamaForCausalLM | 1,100,048,384 | 2048 | 22 | 否 | 32,000 | 2,048 |
| qwen2.5-3b | Qwen2ForCausalLM | 3,085,938,688 | 2048 | 36 | 是 | 151,936 | 32,768 |
| qwen3-4b | Qwen3ForCausalLM | 4,022,468,096 | 2560 | 36 | 是 | 151,936 | 40,960 |
| gemma-4-e2b | Gemma4ForConditionalGeneration | 5,123,178,979 | 1536 | 35 | 是 | 262,144 | 131,072 |
对照对:Qwen2.5-0.5B(tied)和 TinyLlama-1.1B(untied)——样本中唯一没有权重绑定的模型;它的输入矩阵(wte)与输出矩阵(lm_head)是分开的,这使得可以测量 H1 在正则化器"之前"和"之后"。
语料:cmq_experiment 项目的 4 个 markdown 文档(README.md, PROJECT.md, FINAL_REPORT_v4.md, report.md)。token 池:最多 8599(Qwen 分词器)/ ~10080–10082(Llama 家族);池大小差异——不同的 BPE 词表把同一段文本切成不同数量的块。整个语料放进 max_pos ≥ 32k 的模型上下文里没问题;SmolLM 和 TinyLlama(max_pos = 2048)使用语料窗口——因此它们在 Exp6 中的长度 L=2048。
测量协议
- Exp7/H1. 128 token。G_total —— 内置 CE-loss 的 backward。G_in —— lm_head 的冻结克隆,沿输入路径对 CE 做 backward(只更新嵌入)。G_out —— no_grad 隐状态 + W' 的新鲜副本,带 HF 位移的手工 CE(只更新输出矩阵)。untied 模型两个梯度一次 backward 取得。代理:每 128 token 计算 embedding 更新引起的 qkv0 扰动与权重更新引起的扰动之间的余弦——共享权重上冲突的直接度量。
- Exp5/H2. 对每一层(层级 0..L,其中层级 0 = 嵌入)取 2048 token 的上下文,隐状态中心化,精确 SVD;PR = 覆盖 90% 方差所需的主成分数。颈部 = 中心化轮廓的 argmin(PRc)。各向异性 —— 层内向量对之间的平均余弦(raw 与 centered)。
- Exp3/H3. 颈部处 gate_proj 权重与传入激活值的精确 SVD;k95(权重) vs k95(激活值),top-10/top-3 奇异方向的能量。
- E4b (H4, 几何).
E_DC = N·‖x̄‖²/Σ‖vᵢ‖²—— 最后一层状态中 DC 能量(共同方向)的占比;两个条件:prefix(连贯语料)vsmixed(按 256 token 打乱的块),N ∈ {100, 1000, 4096, 8192},一个模型 A。 - E4e/E4f (H4, 功能). 模型 A 上的 pattern-completion 探针:唯一代码(
KZVX-9281+ 2 个类似物)被嵌入到上下文的 p 位置;lift = Δlogit(目标 token vs 替代) 减去无针的控制运行。E4e —— 按长度(L ∈ {100, 500, 1000, 2048, 4096, 8192});E4f —— 按位置:L ∈ {2048, 4096, 8192} × p = 0.05…0.95(步长 0.1)× 3 reps → 90 个单元格 + 9 个控制。 - Exp6 (跨模型). 六个模型上的 per-position lift,位置 [0.05, 0.25, 0.45, 0.75, 0.95],每格 2 reps;Inversion Contrast = Mean Lift(中部) − Mean Lift(两端);> 0 → inverted-U,< 0 → 经典 U / LiM 方向。
所有结果在 _work/exp{5,6,7}_metrics.json、cross_model_results.json 和 _work/neck_zone_stats.json;汇总表格 —— 在 SUMMARY.md。
第三部分. 结果
假设 1 —— 梯度干涉作为输出的暴政
#### 方法
对每个模型取 128 token 的一次运行。G_total —— 内置 CE-loss 的 backward(更新全部参数)。然后是两个"分离"的梯度:G_in —— lm_head 冻结克隆,使得只有输入嵌入被更新;G_out —— no_grad 隐状态 + W' 新鲜副本,带标准 HF 位移的手工 CE,只更新输出矩阵。G_in 与 G_out 之间的余弦度量对立程度:若两条路径在共享矩阵上冲突,则余弦应显著为负。代理指标:对每个 128 token,计算嵌入更新(G_in)引起的第一个 qkv0 状态扰动与 lm_head 权重更新(G_out)引起的扰动之间的平均余弦距离——这是共享权重被表示空间中不同方向拉扯的直接度量。
#### 对照对(原始 Exp1)
| 指标 | tied Qwen-0.5B (A) | untied TinyLlama-1.1b (B) |
|---|---|---|
| 共享 W 上 cos(G_in, G_out) | +0.018(正交) | n/a(分开矩阵:cos(G_emb, G_lm) = +0.0013) |
| 范数比 out/in (lm/emb) | 3.754 | 0.998 |
| cos(G_total, G_out) | 0.967 —— 输出路径吞掉整个更新 | — |
| 代理:emb-更新对 qkv_L0 的影响 | +0.007 | +0.002 |
在 tied 模型中,输出路径按范数主导 3.754×,且 G_total 几乎与之重合(cos = 0.967):输入角色的梯度被"压制"。untied 模型中范数均衡(比值 0.998),路径正交(cos +0.0013):分开的矩阵不产生干涉。两种情形下代理冲突都可忽略(≤ 0.007):共享权重没有被"撕扯"到不同方向。
!
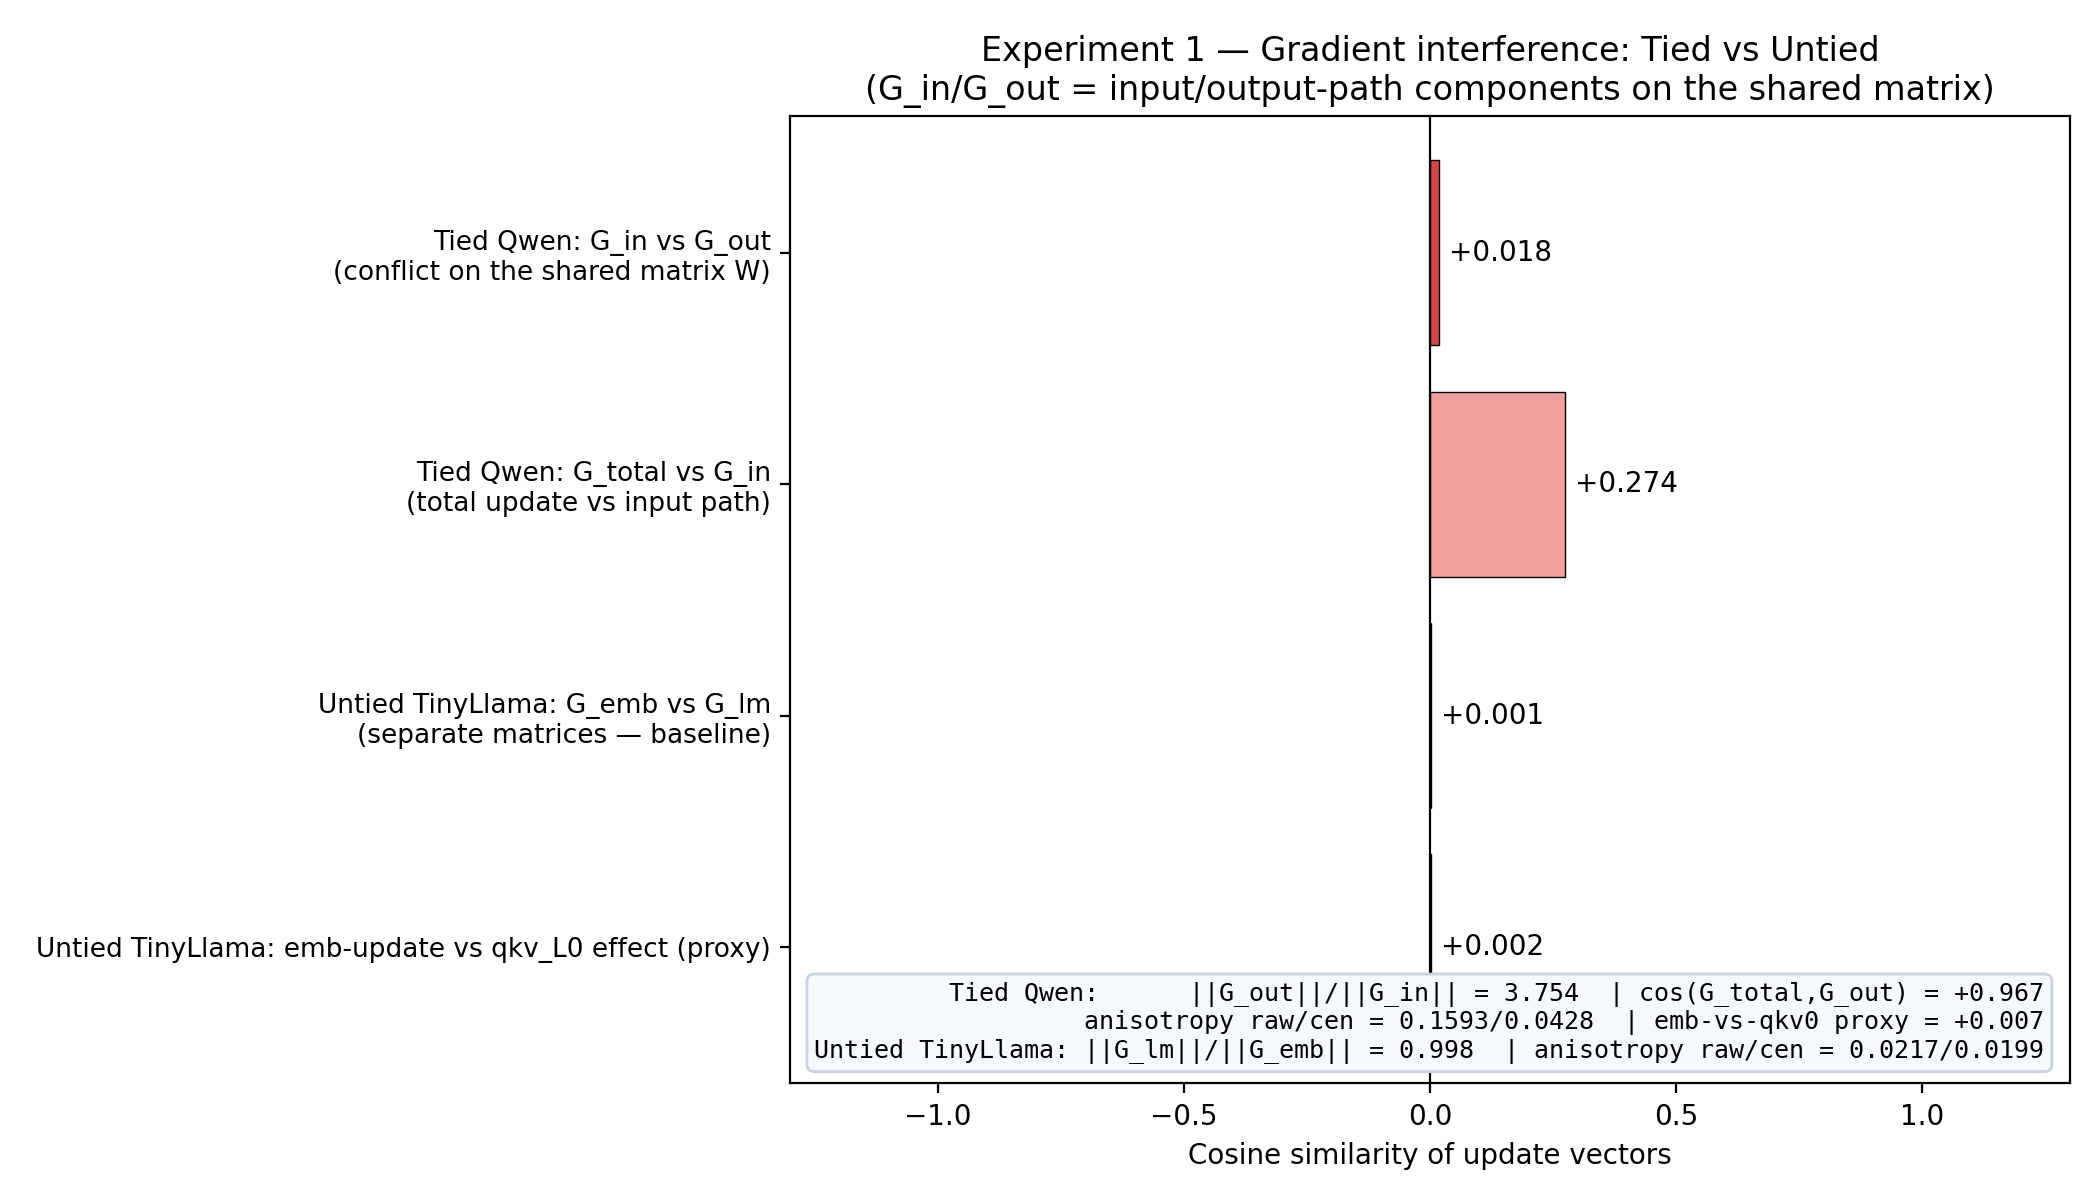
图 1. 共享矩阵上 G_in/G_out 的范数与余弦:Qwen2.5-0.5B(tied,输出主导 ×3.754),TinyLlama-1.1b(untied,均衡,正交)。
#### 跨模型 Exp7:六个模型
| 模型 | Tying? | cos(G_in,G_out) | 范数比 out/in | 代理 |
|---|---|---|---|---|
| smollm-135m | tied | +0.0155 | 4.416 | +0.0014 |
| qwen2.5-0.5b | tied | +0.0183 | 3.754 | +0.0073 |
| tinyllama-1.1b | untied | +0.0013(分开矩阵) | 0.998 | +0.0022 |
| qwen2.5-3b | tied | −0.0061 | 6.953 | +0.1748 |
| qwen3-4b | tied | −0.0036 | 5.496 | +0.2231 |
| gemma-4-e2b | tied | +0.0229 | 0.021 —— 反转 | +0.1197 |
三个观察。
第一:处处没有对立。 G_in/G_out 的余弦落在 [−0.006, +0.023] 区间——这是噪声范围内的正交性。"输入路径把嵌入拉向与输出路径相反的方向"这一假设在全部六个案例中被证伪:两条路径的梯度并不对抗,它们几乎相互垂直。共享矩阵上的干涉不是斗争,而是共存。
第二:干涉表现为主导。 五个 tied 模型中的四个,输出路径按范数主导 ×3.75–6.95,且 G_total 几乎与之重合(cos(G_total,G_out) ≥ 0.967)。我们称之为"输出路径的暴政":共享正则化器不制造冲突——它使两条路径中的一条对共享矩阵变得微不足道。同一方向给出一个由 H2 证实的预测:若输出路径主导共享矩阵,则嵌入空间是为解码(输出)而非编码优化的——因此它是锥形的。
第三:在 Gemma-4 上图景反转。 ‖G_in‖ = 664 vs ‖G_out‖ = 13.97,cos(G_total,G_in) = 0.9997 —— 输入路径主导。两个诚实的限制。第一,矩阵的梯度范数取决于其大小(Gemma 的嵌入是 1536×262144——本选择中最大的),因此跨模型范数比不直接可比;可比的只有每个模型内部的主导方向。第二,在 Gemma4 中嵌入的输出经过缩放(包装类 Gemma4TextScaledWordEmbedding):输入路径的梯度对这个乘子求导,大尺度下 ‖G_in‖ 与其成正比增长。这是反转的自然解释:不是"输入压倒输出",而是嵌入缩放放大了输入梯度——这一解读可以通过从模型代码中读出缩放因子来检验。据我们所知,这是在共享矩阵上首次有文献记载的主导权反转观察:tied decoder 的文献讨论的是"输出的暴政";其反转没有任何来源报告过——该机制需要单独研究。
代理趋势。 代理冲突随模型规模增长:0.0014(SmolLM)→ 0.0073(Qwen0.5B)→ 0.2231(Qwen3-4B),在 untied TinyLlama 中则是大模型里最小的(0.0022)。方向与预期一致:模型越大,输入路径与输出路径在表示空间中"分道扬镳"得越厉害——但即使是最大值 0.22 也离冲突很远;这是方向的适度背离,不是对立。
!
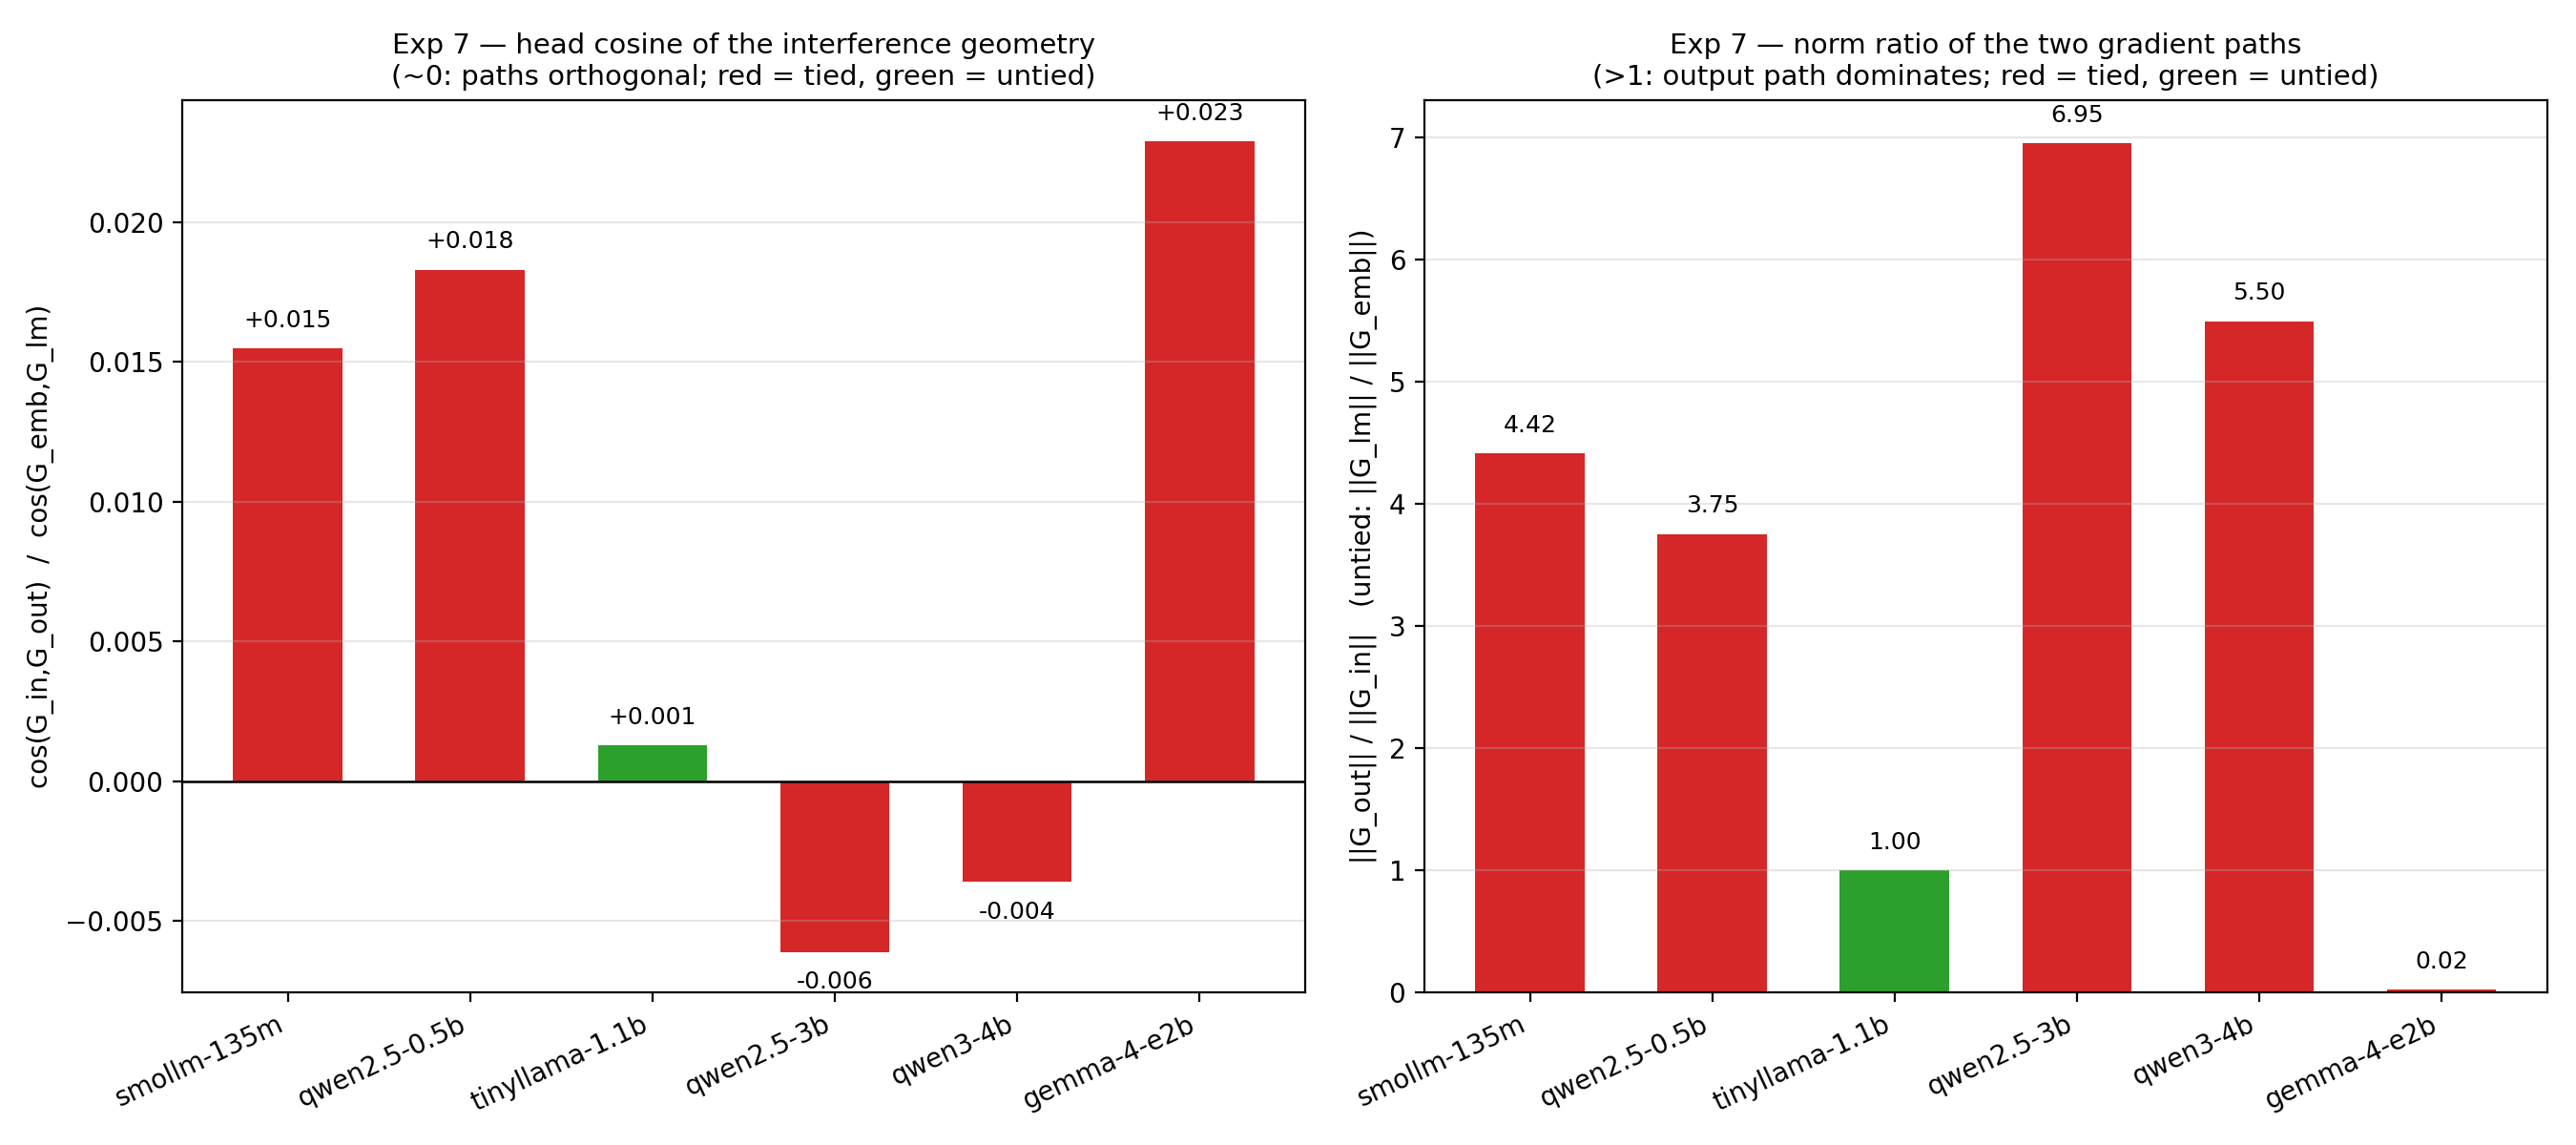
图 2. 六个模型(Exp7)的输入/输出梯度范数与余弦:四个 tied 模型输出主导,Gemma-4 反转。
!
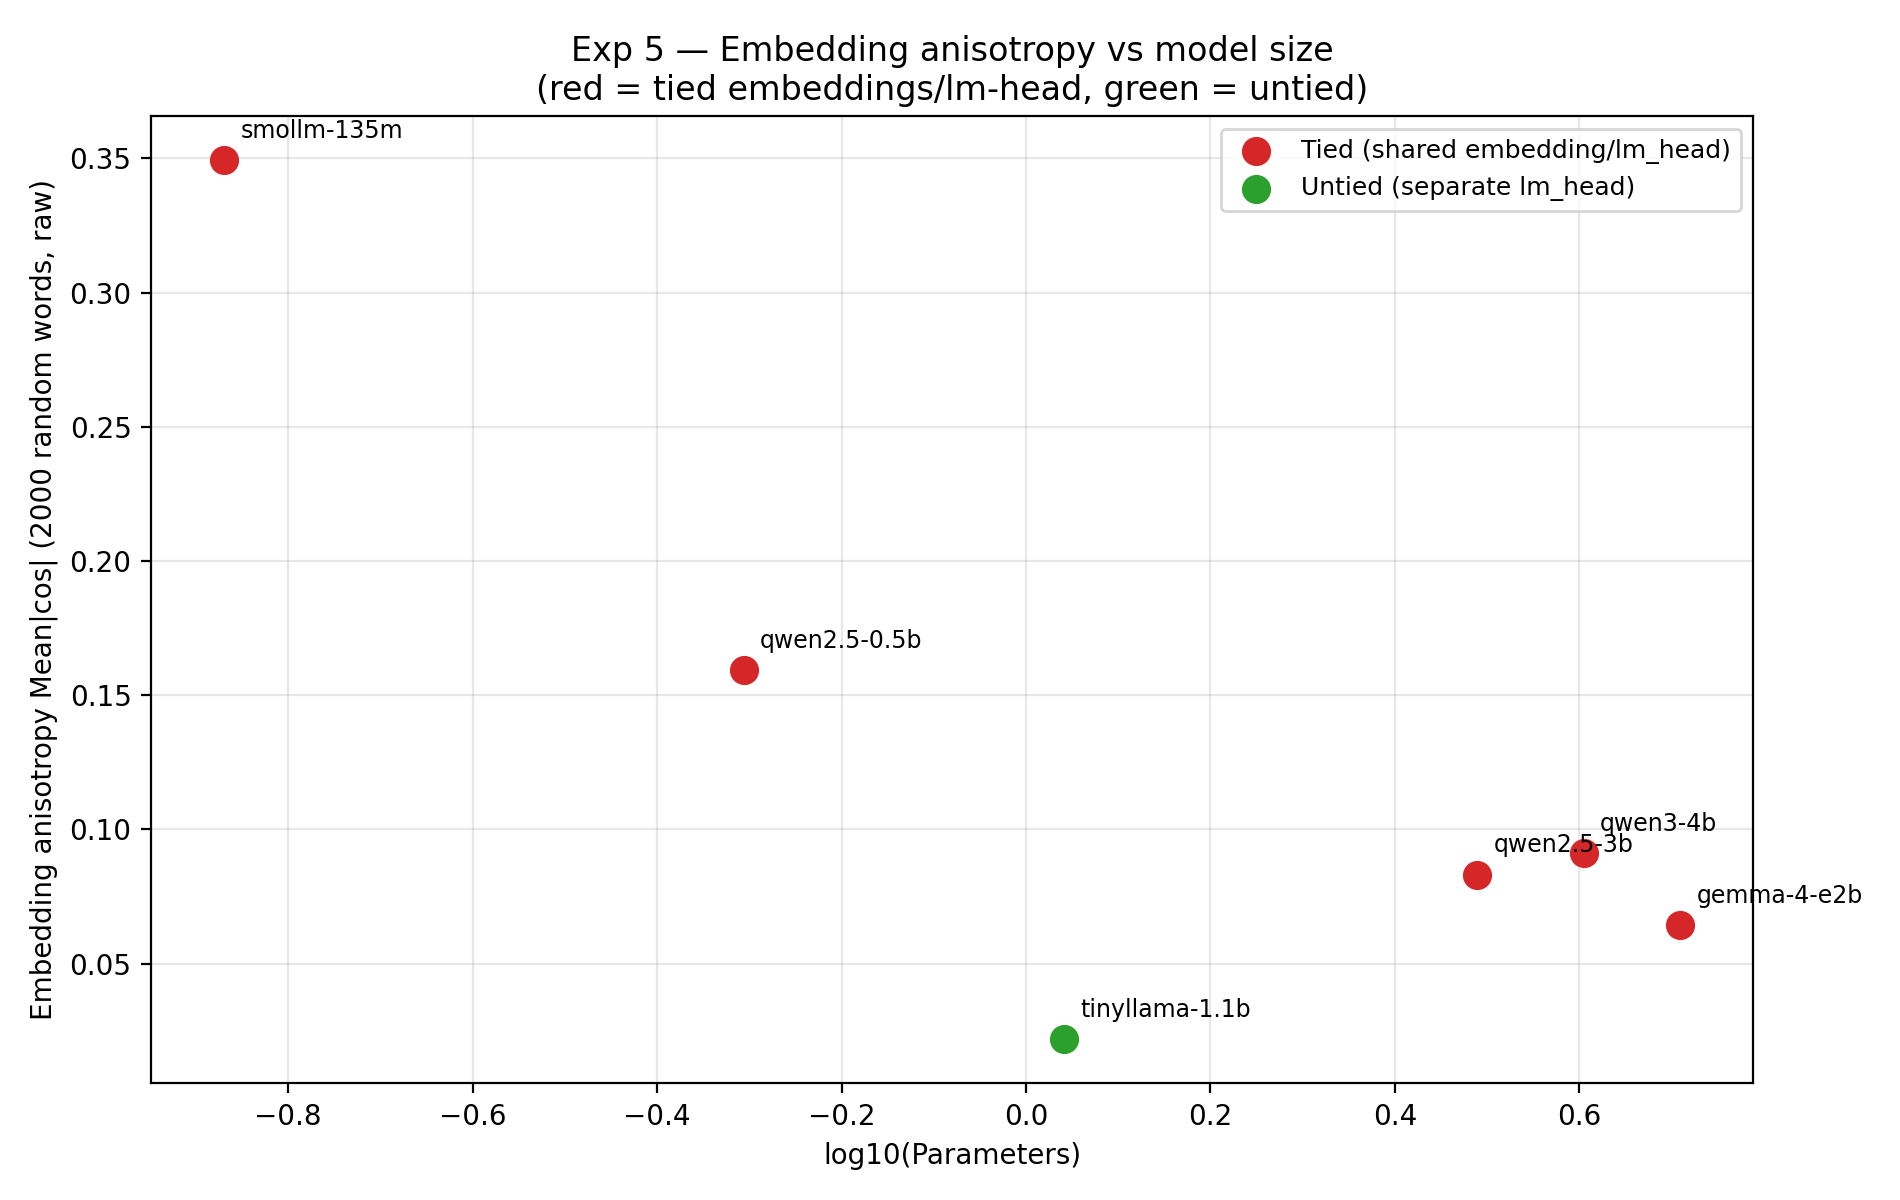
图 3. 嵌入空间各向异性(raw 与 centered)随规模变化:tied 模型被变形为锥,唯一的 untied TinyLlama —— 最小各向异性。
#### 假设 1 的裁决:以异常形式部分证实——在所有六个模型上复现
Weight tying(权重绑定)确实充当正则化器,但机制不是"梯度对立"而是单一路径的主导:共享的输出路径主导嵌入矩阵(五个 tied 模型中的四个 cos(G_total,G_out) ≥ 0.967),输入路径边际。代理冲突处处很小但随模型规模单调增长,且在 untied TinyLlama 中最小——方向与假设一致。Gemma-4 上主导权反转到输入路径(嵌入缩放);这不破坏图景而是细化它:正则化器总是选出一个赢家,但赢家取决于架构。
假设 2 —— 通用沙漏及其代际漂移
#### 方法
对每个堆栈层级(0 = 嵌入,1..L = transformer 块),取 2048 token 的上下文,隐状态按均值中心化,做精确 SVD。PR —— 解释 90% 方差的主成分数(raw);PRc —— 中心化状态的同一指标。沙漏颈部 = PRc 最小的层级。另外计算层各向异性 —— 向量对之间的平均余弦(raw 与 centered)。
#### 对照对(原始 Exp2)
| 指标 | tied Qwen-0.5B (A) | untied TinyLlama-1.1b (B) |
|---|---|---|
| PR(L0) —— 嵌入 | 25.88 | 155.83 |
| PR 中层级(L12 / L11) | 1.37 | 2.12 |
| PR 最后一层 | 7.64 | 30.36 |
| 颈部(最小 centered PR) | L4, PR = 1.17 | L3, PR = 1.13 |
两个模型都给出 wide–narrow–wide:宽输入端,窄颈(PR ≈ 1.2——实际上秩为 1),更宽的输出端。TZ 标准 —— "形状像沙漏"(不要求对称)—— 两个模型都通过。已记录的不对称性(caveat):在输入边缘坍缩(L3–L4),然后是长的低位平台,恢复只在最后 ~5 层 —— Qwen:raw PR 峰值 ≈91 @ L1、≈68 @ L22–23;TinyLlama:单调增长到 57 @ L21。tied 与 untied 的颈部几乎相同(1.17 vs 1.13)→ 低维吸引子是小 LLM 在此上下文下的性质,不是 tying 特有的。这已经暗示沙漏的形状取决于架构,而不只是权重绑定。
!
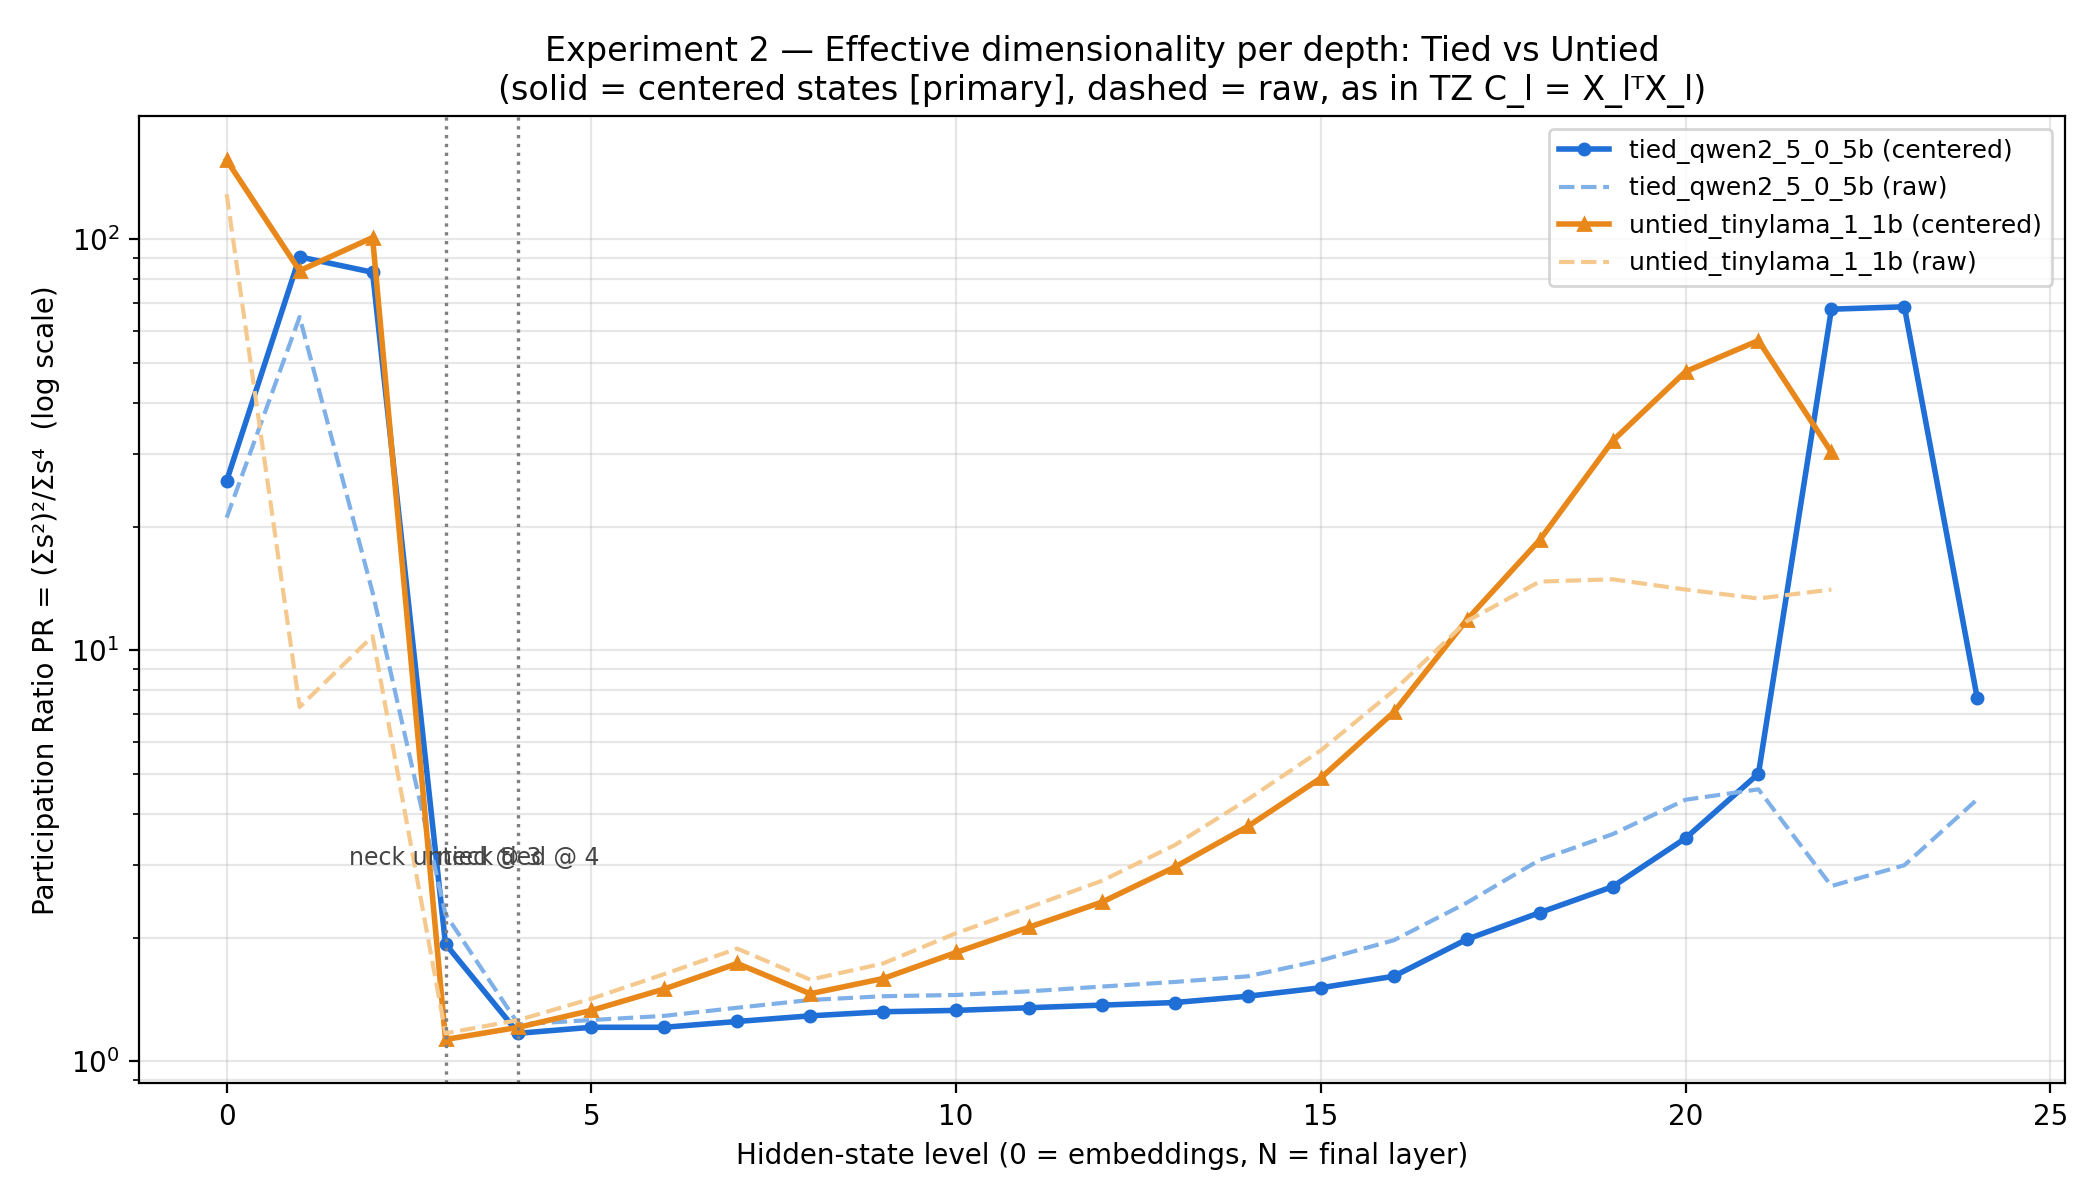
图 4. Qwen2.5-0.5B(tied)与 TinyLlama-1.1b(untied)堆栈的 principal-rank 剖面:wide–narrow–wide,颈部 L4(PR 1.17)/ L3(PR 1.13),不对称 —— 输入边缘坍缩、最后几层恢复。
#### 六个模型的颈部(Exp5)
| 模型 | L | 颈部(层级) | 颈部深度 | PRc(颈部) |
|---|---|---|---|---|
| smollm-135m | 30 | L12 | 40% | 1.08 |
| qwen2.5-0.5b | 24 | L4 | 17% | 1.17 |
| tinyllama-1.1b | 22 | L3 | 14% | 1.13 |
| qwen2.5-3b | 36 | L3 | 8% | 1.10 |
| qwen3-4b | 36 | L17(堆栈中部) | 47% | 1.13 |
| gemma-4-e2b | 35 | L35(lm_head 前的最后一个块) | 无中段压缩 | 6.00 |
Gemma 的 centered PR 在所有层都保持高位(≈ 33–122),只在最后一级降到 6.0:没有中段坍缩;它的"瓶颈"在输出边缘,且比其他模型的颈部疏松约 5×(PR 6 vs ≈ 1.1)。
嵌入各向异性(raw / centered):smollm 0.349/0.059;qwen0.5b 0.159/0.043;tinyllama 0.022/0.020;qwen3b 0.083/0.021;qwen4b 0.091/0.019;gemma 0.064/0.027。唯一的 untied 模型各向异性最小(0.022)——方向与 H1 一致:没有共享正则化器,嵌入空间不像 tied 模型那样被强烈地变形为锥(在不均衡样本 5 tied / 1 untied 上这是观察而非统计)。
#### 压缩区:从瓶颈到层混合
"颈部"作为单点最小值——是一个粗糙的模型。我们对低维区做了定量刻画(cross_model/compute_zone_stats.py,_work/neck_zone_stats.json):n_low = PRc < T=2 的堆栈层级数(1..L)(PR ≈ 2 意味着有效秩接近 2);zone = 包含颈部的最大连通 sub-T 层级序列;局部极小值 —— 剖面中低于阈值的内部凹陷。
| 模型 | n_low / L | 颈部周围的 zone | 宽度 | zone 起点(深度占比) | 局部极小值 <2 | 机制 |
|---|---|---|---|---|---|---|
| smollm-135m | 14/30 (47%) | L12–L25 | 14(深度的 47%) | 0.40 | {L12} | 居中沙漏 |
| qwen2.5-0.5b | 15/24 (62%) | L3–L17 | 15 (62%) | 0.12 | {L4} | 早期漏斗 |
| tinyllama-1.1b | 8/22 (36%) | L3–L10 | 8 (36%) | 0.14 | {L3, L8} | 早期漏斗,双腰 |
| qwen2.5-3b | 22/36 (61%) | L3–L24 | 22 (61%) | 0.08 | {L3} | 早期漏斗 / 长平台 |
| qwen3-4b | 20/36 (56%) | L7–L26 | 20 (56%) | 0.19 | {L7, L11, L17} | 居中沙漏,三腰 |
| gemma-4-e2b | 0/35 (0%) | 无 (<2);T=10 时:仅 L35(PRc 6.0) | — | 1.00 | {} | 分布式机制,输出端压缩 |
三种机制与代际漂移。老一代(Qwen2.5 ×2、TinyLlama)在输入处立即构建低维区:起点为深度的 8–14%,不对称漏斗——经典意义上的"瓶颈"。TinyLlama 的 zone 内部有两个凹陷(L3 和 L8)——层混合的原初雏形。中代(SmolLM)把 zone 居中:起点 0.40,宽度 14 层,单一极小值在中部(L12)。新一代分裂成两个向量。Qwen3-4B —— 本选择中最居中的沙漏(宽度为深度的 56%),但它的腰部由三个压缩极小值 L7/L11/L17 构成:这正是"压缩层的混合"——模型不把信息折叠进单一颈部,而是以一条内部有结构的宽带维持低维性,即多个吸引子"节点"分布在堆栈中。Gemma-4 走得更远,超出沙漏:完全没有中段压缩(严格阈值下 n_low = 0;整个堆栈 PRc 33–122),只有最后一个块被压缩(PRc 6.0,比其他模型的颈部疏松五倍)。可能的机制 —— sliding-window attention:35 层中 28 层以 512 token 的窗口工作,表示不需要跨堆栈的全局压缩,因为每层都是局部的;只有输出被集中。这是一种解读,需要单独实验(窗口消融)验证,但定量上图景"沙漏 → 分布式机制"已被记录:zone 起点从 0.08 随架构更新移向 1.00。这一漂移预测各模型 recall 位置剖面的差异——该联系由下文跨模型 LiM 扫描(Exp6)检验。
诚实的限制:n = 6 个模型、三个家族,交叉比较被规模和架构混杂;SmolLM —— 一个带居中 zone 的小模型,所以"越新 = 越居中"在规模上不是严格单调的,而是描述代际趋势(Qwen2.5 → Qwen3, Gemma)。尽管如此,zone 的形状在每个模型上都独立于规模可复现:五个标准模型的 zone 都覆盖堆栈深度的 36–62% —— "沙漏"不是一个点而是一个延展结构。
!
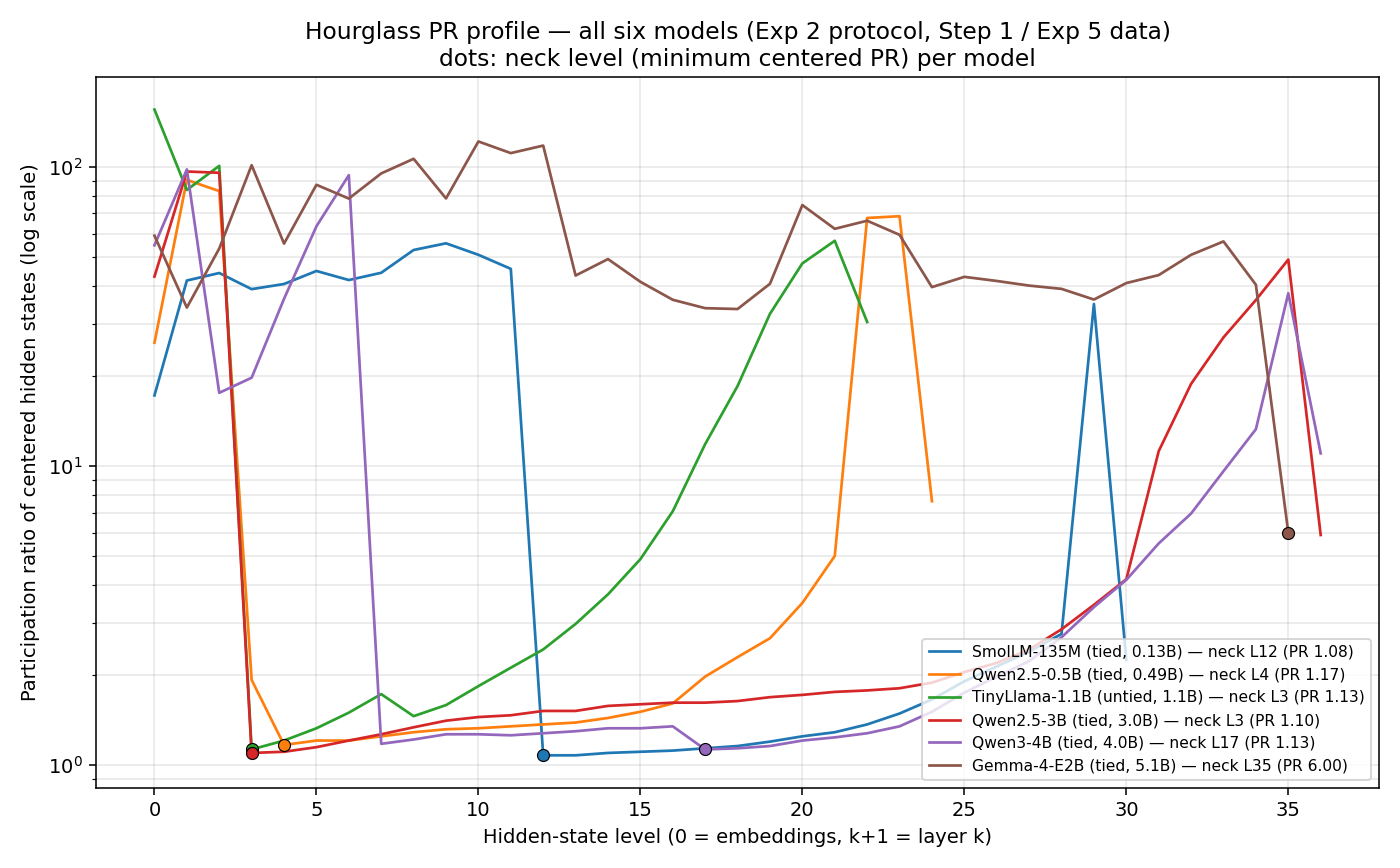
图 5. 六个模型完整 PR 剖面对同一轴:Qwen2.5/TinyLlama 输入端漏斗,SmolLM 和 Qwen3-4B 居中宽带(三腰),Gemma 平坦剖面、只在输出端压缩。
#### 假设 2 的裁决:在六个模型中的五个上得到证实(Gemma —— 例外)
五个标准模型都在堆栈中显示低维 zone,颈部 PRc ≈ 1.1–1.2;zone 覆盖至多 62% 的深度,且 zone 形状随代际漂移:早期瓶颈(Qwen2.5, TinyLlama)→ 居中沙漏(SmolLM)→ 腰部带压缩层混合的沙漏(Qwen3-4B:三个极小值 L7/L11/L17)→ 无中段颈部的分布式机制(Gemma-4,可能 —— sliding-window attention 的后果)。"中部一个颈部"的普遍性被证伪;普遍的是延展低维 zone 的存在及其在新架构中向输出/分布的移动。